review josh-verilog-6
This commit is contained in:

+3
-3
@@ -110,9 +110,9 @@ deploy:
|
||||
- type: git
|
||||
repo: [email protected]:/home/josh/documents/josh-blog-deploy.git
|
||||
branch: master
|
||||
# - type: git
|
||||
# repo: [email protected]:/home/josh/documents/josh-blog.git
|
||||
# branch: master
|
||||
- type: git
|
||||
repo: [email protected]:/home/josh/documents/josh-blog-deploy.git
|
||||
branch: master
|
||||
- type: git
|
||||
repo: [email protected]:josh-gao/josh-blog/josh-blog.git
|
||||
branch: master
|
||||
|
||||
@@ -29,7 +29,7 @@ description: 状态机是逻辑设计的重要内容,其设计水平直接反
|
||||
|
||||
本节的重点在于理解状态机的基本概念和应用场合。
|
||||
|
||||
## 1.1. 状态机是一种思想方法
|
||||
## 1.1. 状态机是一种思想方法<a id="toc.1.1"></a>
|
||||
|
||||
大多数工科生在学习数字电路时都学习过状态机的基本概念,了解一些使用状态机描述时序电路的基本方法。但是**状态机不仅仅是一种时序电路设计工具,它更是一种思想方法**。
|
||||
|
||||
@@ -38,7 +38,9 @@ description: 状态机是逻辑设计的重要内容,其设计水平直接反
|
||||
先看一个简单的例子。在大学生活中,某同学的在校生活可以简单地概括为宿舍、教室、食堂之间的周而复始,可以用[图 6-1](#fig.6-1) 形象地表现出来。这张图并不是要讨论这个学生是否是一个“乖乖”类型学生。
|
||||
|
||||
{% note info %}
|
||||
|
||||
请注意,如果将图中的“地点”认为是“状态”,将“功能“认为是状态的“输出”,这张图就是一张标准的状态转移图,也就是说,用状态机的方式清晰地描述了这个学生的在校生活方式。
|
||||
|
||||
{% endnote %}
|
||||
|
||||
<a id="fig.6-1"></a>
|
||||
@@ -52,7 +54,9 @@ description: 状态机是逻辑设计的重要内容,其设计水平直接反
|
||||
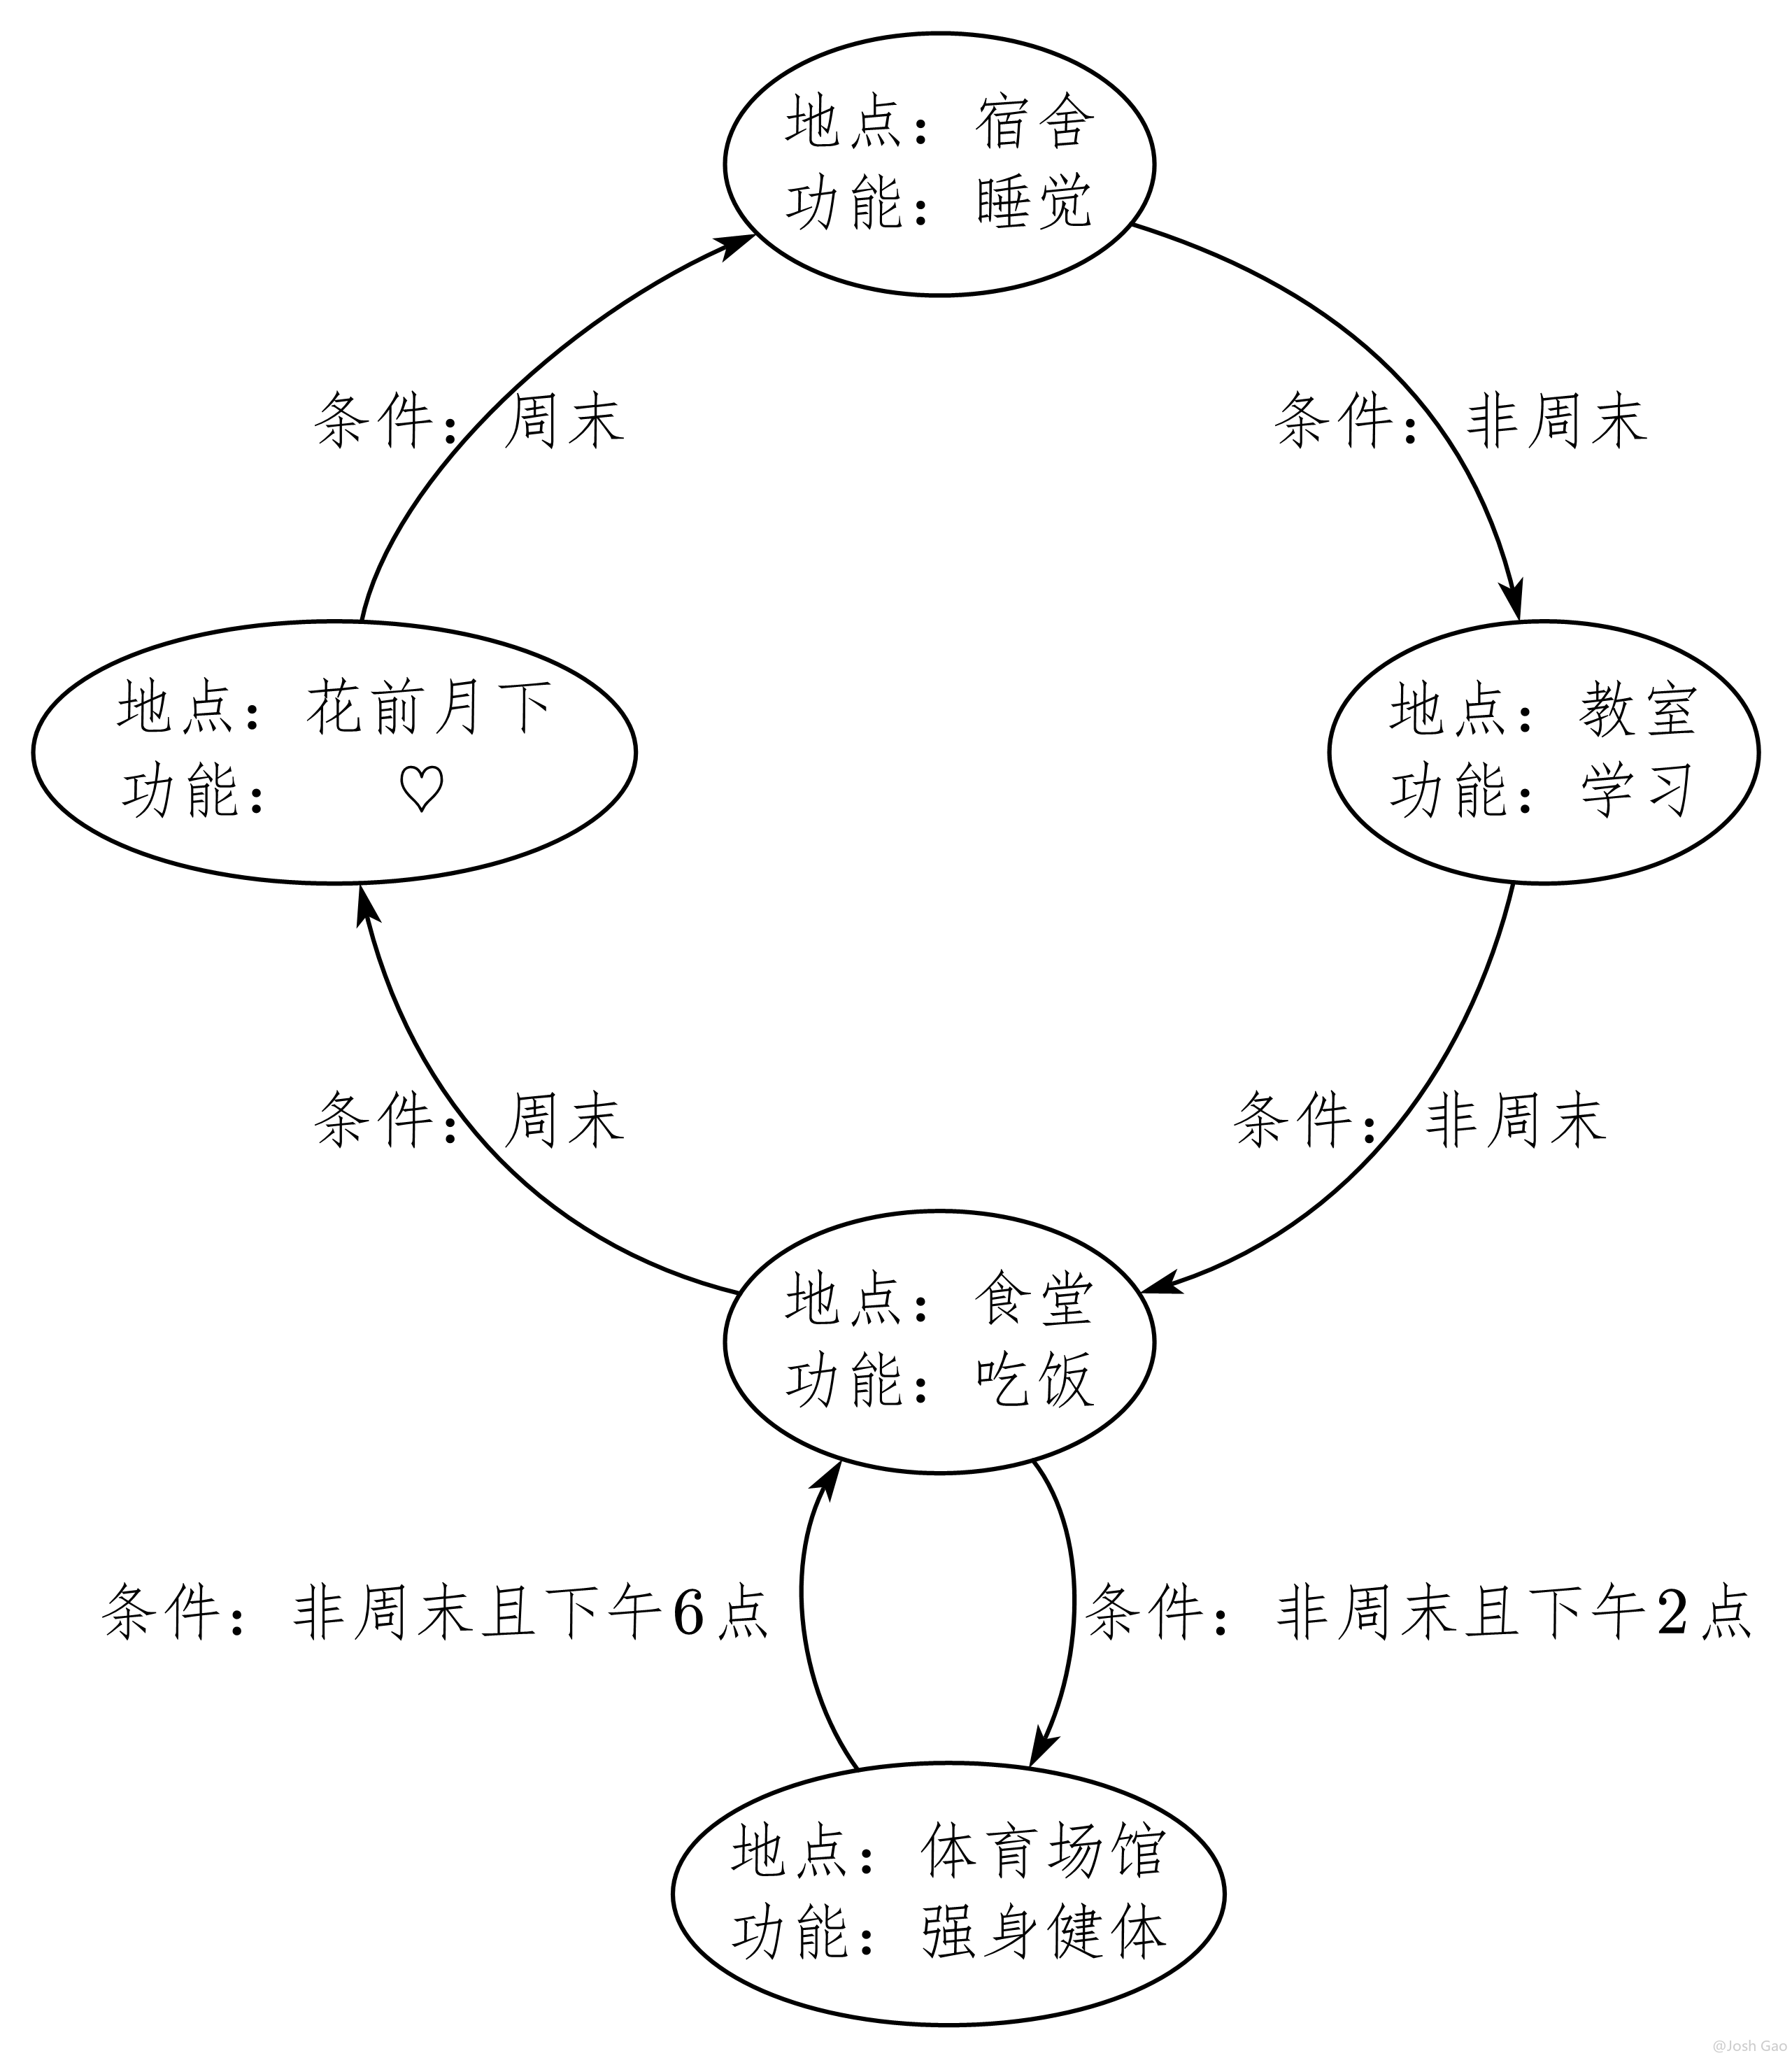{width=600}
|
||||
|
||||
{% note info %}
|
||||
|
||||
同样如果将图中的“地点”认为是“状态”,将“功能”认为是状态的“输出”,将“条件”认为是状态转移的“输入条件”,[图 6-2](#fig.6-2) 也是一张标准的状态转移图,通过状态机的方式再次清晰地描述了另一个学生的在校生活方式。
|
||||
|
||||
{% endnote %}
|
||||
|
||||
事实上使用状态机可以细致入微地描述任何一位同学的在校生活方式。通过前面两个简单举例可以发现,**状态机特别适合描述有发生有先后顺序,或者有逻辑规律的事情**——这就是状态机的本质——对具有逻辑顺序或时序规律事件的一种描述方法。这个论断最重要的两个词就是“**逻辑顺序**”和“**时序规律**”,这两点就是状态机所要描述的核心和强项,换言之,**所有具有逻辑顺序和时序规律的事情都适合用状态机描述**。
|
||||
@@ -63,7 +67,7 @@ description: 状态机是逻辑设计的重要内容,其设计水平直接反
|
||||
|
||||
## 1.2. 状态机的基本要素与分类
|
||||
|
||||
状态机的基本要素有 3 个,其实在[第一小节](#11__7)的举例中都有涉及,只是没有点明,它们是:**状态**、**输出**和**输入**。
|
||||
状态机的基本要素有 3 个,其实在[第一小节](#toc.1.1)的举例中都有涉及,只是没有点明,它们是:**状态**、**输出**和**输入**。
|
||||
|
||||
- **状态**:也叫状态变量。在逻辑设计中,使用状态划分逻辑顺序和时序规律。比如,设计伪随机码发生器时,可以用移位寄存器序列作为状态;在设计电机控制电路时,可以以电机的不同转速作为状态;在设计通信系统时,可以用信号的状态作为状态变量等。
|
||||
|
||||
@@ -77,7 +81,7 @@ description: 状态机是逻辑设计的重要内容,其设计水平直接反
|
||||
|
||||
- **米里型状态机**:米里型状态机的**输出不仅依赖于当前状态,而且取决于该状态的输入条件**。例如[图 6-2](#fig.6-2) 所示的例子,将图中的“地点”认为是“状态”,将“功能”认为是状态的“输出”,将“条件”认为是状态转移的“输入条件”,可以发现,该学生到达什么地方,做什么事情都是由当前状态和输入条件共同决定,所以它是一个米里型状态机。
|
||||
|
||||
根据状态机的数掀是否为有限个,可将状态机分为有限状态机 (Finite State Machine, FSM) 和无限状态机 (Infinite State Machine, ISM)。**逻辑设计中一般所涉及的状态都是有限的,所以以后所说的状态机都指有限状态机,用 FSM 表示。**
|
||||
根据状态机的数掀是否为有限个,可将状态机分为有限状态机 (Finite State Machine, FSM) 和无限状态机 (Infinite State Machine, ISM)。**逻辑设计中一般所涉及的状态都是有限的,所以以后所说的状态机都指有限状态机**,用 FSM 表示。
|
||||
|
||||
## 1.3. 状态机的基本描述方式
|
||||
|
||||
@@ -85,7 +89,7 @@ description: 状态机是逻辑设计的重要内容,其设计水平直接反
|
||||
|
||||
### 1.3.1. 状态转移图
|
||||
|
||||
状态转移图是状态机描述的最自然的方式。如本章第一节[图 6-1](#fig.6-1)、[图 6-2](#fig.6-2) 都使用了状态转移图这一描述方式。状态转移图经常在设计规划阶段定义逻辑功能时使用,也可以在分析代码中状态机时使用,通过图形化的方式非常有助于理解设计意图。
|
||||
状态转移图是状态机描述的最自然的方式。如[图 6-1](#fig.6-1)、[图 6-2](#fig.6-2) 都使用了状态转移图这一描述方式。状态转移图经常在设计规划阶段定义逻辑功能时使用,也可以在分析代码中状态机时使用,通过图形化的方式非常有助于理解设计意图。
|
||||
|
||||
另外值得一提的是目前有一些 EDA 工具支持状态转移图作为逻辑设计的输入,如 StateCAD。在该工具中设计者只要画出状态转移图就可以了, StateCAD 能自动将状态转移图翻译成 HDL 语言代码,而且翻译出来的代码规范、可读性较好、可综合、易维护。 StateCAD 还能自动检测状态机的完备性和正确性,对状态转移图中的冗余状态、自锁状态、歧义转移条件和不完备状态机等隐含错误都会报警,并协助设计者更正错误。最后 StateCAD 会自动生成设计的测试激励,并调用仿真程序,验证状态机的正确性,这个测试激励甚至可在后仿真中使用。总之, StateCAD 提供了状态机的输入、翻译、检测、优化和测试等一条龙的服务,使状态机的设计变得安全、可靠、快速、便捷。这类自动转换状态转移图为 HDL 源代码的工具对设计、分析一些规模较小的状态机非常有效,但是由于自动反应的代码过于程式化,效率不是很高,所以对于较大规模的逻辑设计,一般还是推荐使用 HDL 语言描述。
|
||||
|
||||
@@ -127,7 +131,7 @@ description: 状态机是逻辑设计的重要内容,其设计水平直接反
|
||||
|
||||
不规范的 FSM 写法很难让其他人解读,甚至过一段时间后设计者也发现很难维护。
|
||||
|
||||
需要说明的是以上所列的各项标准,特别是前 3 项标准绝不是割裂的,它们直接有紧密的内在联系。前面花了相当长的篇幅论述 FPGA/CPLD 设计评判的两个基本标准:面积和速度。这里“面积”是指一个设计所消耗 FPGA/CPLD 的逻辑资源数量;“速度”指设计在芯片上稳定运行所能够达到的最高频率。两者是对立统一的矛盾体,要求 一 个设计同时具备设计面积最小,运行频率最高,这是不现实的。科学的设计目标应该是:**在满足设计时序要求(包含对设计最高频率的要求)的前提下,占用最小的芯片面积,或者在所规定的面积下,使设计的时序余量更大,频率更高**。
|
||||
需要说明的是以上所列的各项标准,特别是前 3 项标准绝不是割裂的,它们直接有紧密的内在联系。前面花了相当长的篇幅论述 FPGA/CPLD 设计评判的两个基本标准:面积和速度。这里“面积”是指一个设计所消耗 FPGA/CPLD 的逻辑资源数量;“速度”指设计在芯片上稳定运行所能够达到的最高频率。两者是对立统一的矛盾体,要求一个设计同时具备设计面积最小,运行频率最高,这是不现实的。科学的设计目标应该是:**在满足设计时序要求(包含对设计最高频率的要求)的前提下,占用最小的芯片面积,或者在所规定的面积下,使设计的时序余量更大,频率更高**。
|
||||
|
||||
另外,如果要求 FSM 安全,则很多时候需要使用“full case”的编码方式,即将状态转移变量的所有向量组合情况都在 FSM 中有相应的处理,这势必意味若要多花更多的设计资源,有时也会影响 FSM 的频率。
|
||||
|
||||
@@ -135,7 +139,7 @@ description: 状态机是逻辑设计的重要内容,其设计水平直接反
|
||||
|
||||
## 2.2. RTL 级状态机描述常用语法<a id=2.2></a>
|
||||
|
||||
在[《Part 2——Verilog 语言基础》](https://josh-gao.top/posts/fd2ca242.html)和[《Part 3——描述方式和设计层次》](https://josh-gao.top/posts/fd117896.html)中论述了 Verilog 的基本语法和常用关键字,其中 RTL 级设计可综合的FSM 相关的常用关键字如下:
|
||||
在 [Part 2——Verilog 语言基础][]和 [Part 3——描述方式和设计层次][]中论述了 Verilog 的基本语法和常用关键字,其中 RTL 级设计可综合的FSM 相关的常用关键字如下:
|
||||
|
||||
1. `wire`、`reg` 等
|
||||
|
||||
@@ -145,7 +149,7 @@ description: 状态机是逻辑设计的重要内容,其设计水平直接反
|
||||
|
||||
用于描述状态名称,增强源代码可读性,简化描述。
|
||||
|
||||
例:某状态机使用初始值为 `0` 的独热码(one-hot)编码方式定义的 4 bit 宽度的状态变量 `NS`(代表 Next State,下一状态)和 `CS`(代表 Current State,当前状态),且状态机包含 5 个具体状态 `IDLE`(空闲状态)、`S1`(工作状态 1)、 `S2`(工作状态 2)、 `S3`(工作状态 3)、`ERROR`(告警状态),则代码如下:
|
||||
例:某状态机使用初始值为 `0` 的**独热码**(one-hot)编码方式定义的 4 bit 宽度的状态变量 `NS`(代表 Next State,下一状态)和 `CS`(代表 Current State,当前状态),且状态机包含 5 个具体状态 `IDLE`(空闲状态)、`S1`(工作状态 1)、 `S2`(工作状态 2)、 `S3`(工作状态 3)、`ERROR`(告警状态),则代码如下:
|
||||
|
||||
``` verilog
|
||||
reg [3:0] NS,CS;
|
||||
@@ -166,7 +170,7 @@ description: 状态机是逻辑设计的重要内容,其设计水平直接反
|
||||
``` verilog
|
||||
// sequential state transition
|
||||
always @(posedge elk or negedge nrst)
|
||||
if (! nrst)
|
||||
if (!nrst)
|
||||
CS <= IDLE;
|
||||
else
|
||||
CS <= NS;
|
||||
@@ -181,7 +185,7 @@ description: 状态机是逻辑设计的重要内容,其设计水平直接反
|
||||
`case/endcase` 是 FSM 描述中最重要的语法关键字 ,要详细讨论一下。 `case/endcase` 的基本语法结构如下:
|
||||
|
||||
``` verilog
|
||||
case (case_ expression)
|
||||
case (case_expression)
|
||||
case_item1 : case_item_statement1;
|
||||
case_item2 : case_item_statement2;
|
||||
case_item3 : case_item_statement3;
|
||||
@@ -190,7 +194,13 @@ description: 状态机是逻辑设计的重要内容,其设计水平直接反
|
||||
endcase
|
||||
```
|
||||
|
||||
其中,`case_expression` 就是 `case` 的判断条件表达式,在 FSM 描述中,它一般为当前状态寄存器;每个 `case_item` 是 `case` 语句的分支列表,在 FSM 描述中,它一般为 FSM 中的所有状态的罗列,从中还可以分析出状态的编码方式; `case_item_statement` 为进入每个 `case_item` 的对应操作,在 FSM 中,即为每个状态对应的状态转移或者输出,如果 `case_item_statement` 包含的操作不只一条,可以用 `begin/end` 嵌套多条操作; `default` 是个可选的关键字,用以指明当所列的所有 `case_item` 与 `case_expression` 都不匹配时的操作,在 FSM 设计中,为了提高设计的安全性,排除所设计的FSM 进入死循环,一般要求加上 `default` 关键字来描述 FSM 所需状态的补集状态下的操作。另外 Verilog 还支持 `casex` 和 `casez` 等不同关键字,但是由于综合器对这两个关键字的支持情况略有差异,所以笔者建议初学者使用完整的 `case` 结构而不使用 `casex` 或 `casez`。
|
||||
其中:
|
||||
|
||||
- `case_expression` 就是 `case` 的判断条件表达式,在 FSM 描述中,它一般为当前状态寄存器;每个 `case_item` 是 `case` 语句的分支列表,在 FSM 描述中,它一般为 FSM 中的所有状态的罗列,从中还可以分析出状态的编码方式;
|
||||
- `case_item_statement` 为进入每个 `case_item` 的对应操作,在 FSM 中,即为每个状态对应的状态转移或者输出,如果 `case_item_statement` 包含的操作不只一条,可以用 `begin/end` 嵌套多条操作;
|
||||
- `default` 是可选的关键字,用以指明当所列的所有 `case_item` 与 `case_expression` 都不匹配时的操作,在 FSM 设计中,为了提高设计的安全性,排除所设计的FSM 进入死循环,一般要求加上 `default` 关键字来描述 FSM 所需状态的补集状态下的操作。
|
||||
|
||||
另外 Verilog 还支持 `casex` 和 `casez` 等不同关键字,但是由于综合器对这两个关键字的支持情况略有差异,所以建议初学者使用完整的 `case` 结构而不使用 `casex` 或 `casez`。
|
||||
|
||||
例:某 FSM 的状态转移用 `case/endcase` 结构描述如下:
|
||||
|
||||
@@ -232,11 +242,11 @@ description: 状态机是逻辑设计的重要内容,其设计水平直接反
|
||||
|
||||
{% endnote %}
|
||||
|
||||
5. `task/ endtask`
|
||||
5. `task/endtask`
|
||||
|
||||
`task/endtask` 在描述状态机时主要用途是将不同状态对应的输出用 `task/endtask` 封装,增强了代码的可维护性和可读性。
|
||||
|
||||
例:某状态机 IDLE 状态的输出可以用 `task/endtask` 封装为 `IDEL_out` 任务:
|
||||
例:某状态机 IDLE 状态的输出可以用 `task/endtask` 封装为 `IDLE_out` 任务:
|
||||
|
||||
``` verilog
|
||||
task IDLE_out;
|
||||
@@ -267,7 +277,7 @@ description: 状态机是逻辑设计的重要内容,其设计水平直接反
|
||||
在这个范例中将用一段式、两段式、三段式分别描述例子的状态转移,如[图 6-3](#fig.6-3) 所示。这里选用了一个非常典型的米里型状态机,共有 4 个状态: `IDEL`、`S1`、`S2`、`ERROR`;输入信号为时钟 `clk`,低电平异步复位信号 `nrst`, 输入信号 `i1`、`i2`,输出信号为 `o1`、`o2` 和 `err`,状态关系如[图 6-3](#fig.6-3) 所示。状态的输出如下:
|
||||
|
||||
``` verilog
|
||||
IDLE 状态的输出为: {o1, o2, err} = 3'6000;
|
||||
IDLE 状态的输出为: {o1, o2, err} = 3'b000;
|
||||
S1 状态的输出为: {o1, o2, err} = 3'b100;
|
||||
S2 状态的输出为: {o1, o2, err} = 3'b010;
|
||||
ERROR 状态的输出为: {o1, o2, err} = 3'b111。
|
||||
@@ -283,7 +293,7 @@ ERROR 状态的输出为: {o1, o2, err} = 3'b111。
|
||||
|
||||
``` verilog state1.v
|
||||
// state1.v
|
||||
// 1-paragraph method to decribe FSM
|
||||
// 1-paragraph method to describe FSM
|
||||
// Describe state transition, state output, state input condition in only 1
|
||||
// always block
|
||||
// Westor, Dec. 2006
|
||||
@@ -460,7 +470,7 @@ endmodule
|
||||
|
||||
本例中,同步时序描述状态转移的 `always` 模块代码如下:
|
||||
|
||||
``` verilog
|
||||
``` verilog state2.v
|
||||
always @(posedge clk or negedge nrst)
|
||||
if (!nrst)
|
||||
CS <= IDLE;
|
||||
@@ -472,7 +482,7 @@ always @(posedge clk or negedge nrst)
|
||||
|
||||
本例中,另一个采用组合逻辑判断状态转移条件的 `always` 模块代码如下:
|
||||
|
||||
```verilog
|
||||
``` verilog state2.v
|
||||
// combinational condition judgment
|
||||
always @(nrst or CS or i1 or i2) begin
|
||||
NS = 3'bx;
|
||||
@@ -507,13 +517,13 @@ end
|
||||
|
||||
这个使用组合逻辑判断状态转移条件的 `always` 模块也**可以看成格式化的书写结构**。其中 `always` 的敏感列表为当前状态 `CS`, 复位信号和输入条件(**如果是米里状态机,则必须有输入条件;如果是摩尔状态机,一般敏感表和后续逻辑判定没有输入**),请大家注意**电平敏感表必须列完整**。本例中这段电平敏感列表为:
|
||||
|
||||
``` verilog
|
||||
``` verilog state2.v
|
||||
always @(nrst or CS or i1 or i2)
|
||||
```
|
||||
|
||||
一般来说,在这个组合 `always` 敏感表下先写一个默认的下一状态 `NS` 的描述,然后根据实际的状态转移条件由内部的 `case` 或者 `if ... else` 条件判断确定正确的转移。如本例中下面这段代码,
|
||||
|
||||
``` verilog
|
||||
``` verilog state2.v
|
||||
// ...
|
||||
begin
|
||||
NS = 3'bx;
|
||||
@@ -522,7 +532,7 @@ begin
|
||||
// ...
|
||||
```
|
||||
|
||||
推荐**在敏感表下的默认状态为不定状态 `X`**, 这样描述的好处有两个:第一在仿真时可以很好地考察所设计的 FSM 的完备性,如果所设计的 FSM 不完备,则会进入任意状态,仿真很容易发现;第二个好处是综合器对不定态 `X` 的处理是 “Don't Care”,即任何没有定义的状态寄存器向最都会被忽略。这里赋值不定态的效果和使用 `casez` 或 `casex` 替代 case 的效果非常相似。
|
||||
推荐**在敏感表下的默认状态为不定状态 `X`**, 这样描述的好处有两个:第一在仿真时可以很好地考察所设计的 FSM 的完备性,如果所设计的 FSM 不完备,则会进入任意状态,仿真很容易发现;第二个好处是综合器对不定态 `X` 的处理是 “Don't Care”,即**任何没有定义的状态寄存器向最都会被忽略**。这里赋值不定态的效果和使用 `casez` 或 `casex` 替代 case 的效果非常相似。
|
||||
|
||||
在每个 `case` 模块内部的结构也非常相似,都是先描述当前状态的组合逻辑输出,然后根据输入条件(米里 FSM) 判定下一个状态。
|
||||
|
||||
@@ -656,7 +666,7 @@ end
|
||||
|
||||
大家可能会问,一段式写法也是用寄存器同步了 FSM 的输出,为什么前面介绍一段式的输出代码容易混淆,不利于维护呢?请大家对比一下这段一段式输出的代码,
|
||||
|
||||
```verilog
|
||||
``` verilog
|
||||
case(NS)
|
||||
IDLE: begin
|
||||
if (~i1) begin{o1,o2,err}<=3'b000;NS <= IDLE; end
|
||||
@@ -681,11 +691,13 @@ case(NS)
|
||||
|
||||
#### 2.3.4.1. n 段式描述方法和 `always` 语法块的个数
|
||||
|
||||
通过学习,大家知道标准的一段式、两段式、三段式 FSM 描述方法分别使用了 1、2、3 个 `always` 语法块。但是请注意,这个命题的反命题不成立,不能说一段 FSM 的描述中使用了 n 个 `always` 语法块,就是 n 段式描述方法。这是因为**特指的一段式、两段式、三段式 FSM 描述方法中每个 `always` 语法块都有固定的描述内容和格式化的结构**,其实也就是通过这些特定的描述内容和格式化的结构,确立了 3 种 FSM 建模方式。例如两段式写法中,第一个 `always` 模块格式化地使用同步时序电路描述次态寄存器到现态寄存器的转移;而第二个 `always` 模块格式化地使用纯组合逻辑描述状态转移条件。 也就是说两段式描述对应的建模方式的硬件电路就是[图 6-5](#fig.6-5) 所示的电路结构。其实从语法角度说,可以将一个 `always` 模块拆分成多个 `always` 模块,或者反之将多个 `always` 模块合并为一个 `always` 模块。所以请注意,**n 段式 FSM 描述方法强调的是一种建模思路,绝不是简单的 `always` 语法块个数**。
|
||||
通过学习,大家知道标准的一段式、两段式、三段式 FSM 描述方法分别使用了 1、2、3 个 `always` 语法块。但是请注意,这个命题的反命题不成立,不能说一段 FSM 的描述中使用了 n 个 `always` 语法块,就是 n 段式描述方法。这是因为**特指的一段式、两段式、三段式 FSM 描述方法中每个 `always` 语法块都有固定的描述内容和格式化的结构**,其实也就是通过这些特定的描述内容和格式化的结构,确立了 3 种 FSM 建模方式。
|
||||
|
||||
例如两段式写法中,第一个 `always` 模块格式化地使用同步时序电路描述次态寄存器到现态寄存器的转移;而第二个 `always` 模块格式化地使用纯组合逻辑描述状态转移条件。 也就是说两段式描述对应的建模方式的硬件电路就是[图 6-5](#fig.6-5) 所示的电路结构。其实从语法角度说,可以将一个 `always` 模块拆分成多个 `always` 模块,或者反之将多个 `always` 模块合并为一个 `always` 模块。所以请注意,**n 段式 FSM 描述方法强调的是一种建模思路,绝不是简单的 `always` 语法块个数**。
|
||||
|
||||
#### 2.3.4.2. FSM 的建模方式
|
||||
|
||||
反复强调的 n 段式描述方法其实是 FSM 的 3 种建模方式。大家回顾一下状态[转移图 6-3](#fig.6-3) 描述的 FSM,在学习本节之前,大家可能会产生各种不同的描述思路,通过本节的学习,希望大家能够自然而然地想到用[图 6-5](#fig.6-5)(对应两段式思路)和[图 6-6](#fig.6-6)(对应三段式思路)的结构建模。其实对于绝大多数 FSM,都可以采用[图 6-4](#fig.6-4)、图 6-5](#fig.6-5) 或[图 6-6](#fig.6-6) 的结构建模。一般来说,推**荐使用后两种结构建模。**这是因为:两段式思路建模结构清晰,描述简洁,便于约束,而且如果允许输出逻辑、允许插入一个节拍,就可以通过插入输出寄存器改善输出逻辑的时序并避免组合逻辑的毛刺;三段式思路建模结构清晰,结构格式化,解决了不改变时序要求的前提下用寄存器做状态输出的问题。请大家仔细研究[图 6-4](#fig.6-4)、[图 6-5](#fig.6-5) 和[图 6-6](#fig.6-6) 体会 3 种建模方式。
|
||||
反复强调的 n 段式描述方法其实是 FSM 的 3 种建模方式。大家回顾一下状态[转移图 6-3](#fig.6-3) 描述的 FSM,在学习本节之前,大家可能会产生各种不同的描述思路,通过本节的学习,希望大家能够自然而然地想到用[图 6-5](#fig.6-5)(对应两段式思路)和[图 6-6](#fig.6-6)(对应三段式思路)的结构建模。其实对于绝大多数 FSM,都可以采用[图 6-4](#fig.6-4)、[图 6-5](#fig.6-5) 或[图 6-6](#fig.6-6) 的结构建模。一般来说,推**荐使用后两种结构建模**。这是因为:两段式思路建模结构清晰,描述简洁,便于约束,而且如果允许输出逻辑、允许插入一个节拍,就可以通过插入输出寄存器改善输出逻辑的时序并避免组合逻辑的毛刺;三段式思路建模结构清晰,结构格式化,解决了不改变时序要求的前提下用寄存器做状态输出的问题。请大家仔细研究[图 6-4](#fig.6-4)、[图 6-5](#fig.6-5) 和[图 6-6](#fig.6-6) 体会 3 种建模方式。
|
||||
|
||||
#### 2.3.4.3. 一段式建模和三段式建模的关系
|
||||
|
||||
@@ -704,10 +716,10 @@ case(NS)
|
||||
一般来说,3 种 FSM 描述方法可以用下表进行比较。但是请注意,任何一种描述的优劣只是一般规律,而不是绝对性规律。例如,一般来说不推荐一段式描述,但是如果 FSM 的结构十分简单,状态很少,状态转移条件和状态输出都十分简化,则使用一段式建模的效率很高。这些经验需要逐步积累,但是在这里推荐的是一般性规律,请结合电路,体会这几种 FSM 建模方法。
|
||||
|
||||
| <center>比较项目</center> | <center>一段式描述方法</center> | <center>两段式描述方法</center> | <center>三段式描述方法</center> |
|
||||
| :-- | :-- | :-- | :-- |
|
||||
| :---- | :-- | :-- | :-- |
|
||||
| 推荐等级 | 不推荐 | 推荐 | 推荐 |
|
||||
| 代码简洁程度<br>(对于相对复杂的FSM而言) | 冗长 | 最简洁 | 简洁 |
|
||||
| `always` 米模块个数 | 1 | 2 | 3 |
|
||||
| 代码简洁程度<br>(对于相对复杂的 FSM 而言) | 冗长 | 最简洁 | 简洁 |
|
||||
| `always` 模块个数 | 1 | 2 | 3 |
|
||||
| 是否利于时序约束 | 不利于 | 利于 | 利于 |
|
||||
| 是否有组合逻辑输出 | 可以无组合逻辑输出 | 多数情况有组合逻辑输出 | 无组合逻辑输出 |
|
||||
| 是否利于综合与布局布线 | 不利于 | 利于 | 利于 |
|
||||
@@ -730,7 +742,7 @@ Binary(二进制编码)、gray-code(格雷码)编码使用最少的触
|
||||
|
||||
### 2.4.3. FSM 状态编码定义
|
||||
|
||||
**状态机的定义可以用 `parameter` 定义,但是不推荐使用 `` `define`` 宏定义的方式**,因为 `` `define`` 宏定义在编译时自动替换整个设计中所定义的宏,而 `parameter` 仅定义模 块内部的参数,定义的参数不会与模块外的其他状态机混淆。例如,一个工程里面有两个 `module`,各包含一个 FSM,如果设计时都有 `IDLE` 这一名称的状态,使用 `` `define``宏定义就会混淆起来,而使用 `parameter` 则不会造成任何不良影响。
|
||||
**状态机的定义可以用 `parameter` 定义,但是不推荐使用 `` `define`` 宏定义的方式**,因为 `` `define`` 宏定义在编译时自动替换整个设计中所定义的宏,而 `parameter` 仅定义模 块内部的参数,定义的参数不会与模块外的其他状态机混淆。例如,一个工程里面有两个 `module`,各包含一个 FSM,如果设计时都有 `IDLE` 这一名称的状态,使用 `` `define`` 宏定义就会混淆起来,而使用 `parameter` 则不会造成任何不良影响。
|
||||
|
||||
### 2.4.4. FSM 输出
|
||||
|
||||
@@ -742,7 +754,9 @@ Binary(二进制编码)、gray-code(格雷码)编码使用最少的触
|
||||
|
||||
### 2.4.6. FSM 的默认状态
|
||||
|
||||
**完整的状态机应该包含一个默认(default)状态**,当转移条件不满足,或者状态发生了突变时,要能保证逻辑不会陷入“死循环”。这是对状态机**健壮性**的一个重要要求,也就是常说的要具备“自恢复”功能。对编码 `case` 和 `if ... else` 语句要特别注意, **尽量使用完备的条件判断语句**。 Verilog 中,使用 `case` 语句的时候要用 `default` 建立默认状态。读者可能注意到,在上节举例的 `case` 语句中,没有写 `default` 默认状态, 其实**可以将其中一个状态不编码,指定其为 `default` 默认状态**,则任何与所列状态机不匹配的状态都会转到 `default` 状态,从而增强了 FSM 的健壮性,另外**也可以添加一个额外的 `default` 状态**,一旦进入这个状态就会自动转到 `IDLE` 状态,从新启动状态机,这样做也增强了状态机的健壮性。
|
||||
**完整的状态机应该包含一个默认(default)状态**,当转移条件不满足,或者状态发生了突变时,要能保证逻辑不会陷入“死循环”。这是对状态机**健壮性**的一个重要要求,也就是常说的要具备“自恢复”功能。对编码 `case` 和 `if ... else` 语句要特别注意, **尽量使用完备的条件判断语句**。 Verilog 中,使用 `case` 语句的时候要用 `default` 建立默认状态。
|
||||
|
||||
大家可能注意到,在上节举例的 `case` 语句中,没有写 `default` 默认状态, 其实**可以将其中一个状态不编码,指定其为 `default` 默认状态**,则任何与所列状态机不匹配的状态都会转到 `default` 状态,从而增强了 FSM 的健壮性,另外**也可以添加一个额外的 `default` 状态**,一旦进入这个状态就会自动转到 `IDLE` 状态,从新启动状态机,这样做也增强了状态机的健壮性。
|
||||
|
||||
``` verilog
|
||||
case (CS)
|
||||
@@ -805,3 +819,6 @@ endcase
|
||||
# 参考文献
|
||||
|
||||
EDA 先锋工作室. *轻松成为设计高手——Verilog HDL 实用精解.* 北京航空航天大学出版社, 2012.
|
||||
|
||||
[Part 2——Verilog 语言基础]: https://josh-gao.top/posts/fd2ca242.html
|
||||
[Part 3——描述方式和设计层次]: https://josh-gao.top/posts/fd117896.html
|
||||
|
||||
@@ -106,7 +106,7 @@ testbench 概念提供了一个很好的验证芯片的平台。
|
||||
|
||||
关于这个设计的验证,在后续笔记将重点介绍。
|
||||
|
||||
## 2.1. 编写仿真激励<a id=2.1></a>
|
||||
## 2.1. 编写仿真激励<a id=toc.2.1></a>
|
||||
|
||||
对于初学者来说,迅速掌握一些常用测试激励的写法非常重要。这样可以有效提高代码的质量,减少错误的产生。
|
||||
|
||||
@@ -114,7 +114,7 @@ testbench 概念提供了一个很好的验证芯片的平台。
|
||||
|
||||
### 2.1.1. 仿真激励与被测对象的连接
|
||||
|
||||
在 [《Part 3——描述方式和设计层次》的 5.1 小节][]中介绍了结构化描述方法的模块实例端口连接关系。
|
||||
在 [Part 3——描述方式和设计层次的 5.1 系统级和行为级]中介绍了结构化描述方法的模块实例端口连接关系。
|
||||
|
||||
同样,在 testbench 中,需要实例化被测试模块(DUV),DUV 的端口和 testbench 中的信号互连也遵循同样的规则。请参考模块实例端口连接规则,如[图 7-6](#fig.7-6) 所示。
|
||||
|
||||
@@ -493,7 +493,7 @@ end
|
||||
|
||||
`force` 和 `release` 并不常用。有时,可以利用它们和仿真工具做简单的交互操作。例如,VerilogXL 的图形界面可以很方便的将一个变量 `force` 为 `0` 或 `1`。而在 testbench 里,可以检测变量是否被 `force` 为固定的值,当被 `force` 为固定的值时就执行预定的操作,实现了简单交互操作。
|
||||
|
||||
### 2.1.10. 封装功能模块<a id=2.1.10></a>
|
||||
### 2.1.10. 封装功能模块<a id=toc.2.1.10></a>
|
||||
|
||||
与 C 语言类似,在编写 testbench 的时候,可以将固定的一些操作封装成任务或者函数。
|
||||
|
||||
@@ -575,7 +575,7 @@ ProductResult = Product(A,B); // 将 A 和 B 的乘积赋给 ProductResult
|
||||
|
||||
那么,如何将待测设计和仿真激励连接起来,是对设计进行仿真的重要一步。
|
||||
|
||||
在[《Part 3——描述方式和设计层次》的 5.1 小节][]和[本篇笔记的 2.1 小节](#2.1)中,都提到了如何在模块中实例化其他模块的方法。大家可以参考这些内容,掌握如何在 testbench 中实例化 DUV 或其他模块。
|
||||
在[Part 3——描述方式和设计层次的 5.1 系统级和行为级][]小节和本文的 [2.1 小节](#toc.2.1)中,都提到了如何在模块中实例化其他模块的方法。大家可以参考这些内容,掌握如何在 testbench 中实例化 DUV 或其他模块。
|
||||
|
||||
将以[图 7-13](#fig.7-13) 中的 testbench 为实例,介绍端口的连接关系。
|
||||
|
||||
@@ -617,7 +617,7 @@ MPI u_MPI(
|
||||
endmodule
|
||||
```
|
||||
|
||||
另外,在Verilog 语言中,也支持多顶层结构。关于多顶层的 testbench,请参考 [4.5.2 小节](#4.5.2)的叙述。
|
||||
另外,在Verilog 语言中,也支持多顶层结构。关于多顶层的 testbench,请参考 [4.5.2 小节](#toc.4.5.2)的叙述。
|
||||
|
||||
将仿真平台建好以后,就可以开始仿真了。
|
||||
|
||||
@@ -716,7 +716,7 @@ VCD 文件是一种标准格式的波形记录文件。该文件只记录发生
|
||||
|
||||
上述仅仅是一些基本的仿真原则,限于篇幅,不能展开论述,希望大家带着问题,在后续学习笔记中作为重点去理解。
|
||||
|
||||
# 3. CPU 接口仿真实例<a id=3></a>
|
||||
# 3. CPU 接口仿真实例<a id=toc.3></a>
|
||||
|
||||
前面介绍了许多编写 testbench 的方法和技巧,现在轮到如何利用这些技巧了。所谓实践出真知,下面就一个常用的实例,帮助大家继续深入体会如何编写 testbench, 如何验证设计。
|
||||
|
||||
@@ -775,7 +775,7 @@ endmodule
|
||||
|
||||
该设计中,输入地址采用 `6` 位,地址 `0~31` 为设计中的块状 RAM(`8` 位宽,`32` 字节深度),地址 `32~47` 为设计中的 D 触发器实现的 `8` 位寄存器,地址 `48~63` 保留未使用。
|
||||
|
||||
## 3.2. 一种 testbench<a id=3.2></a>
|
||||
## 3.2. 一种 testbench<a id=toc.3.2></a>
|
||||
|
||||
以下介绍一种 testbench,供大家学习使用。使用 `$random` 产生激励,用 `$display` 输出仿真结果。
|
||||
|
||||
@@ -873,9 +873,9 @@ endmodule
|
||||
|
||||
为了检查读/写数据是否一致,只需要查看以上的显示内容即可。另外,还可以通过查看具体的波形来调试。
|
||||
|
||||
## 3.3. 另一种 testbench<a id=3.3></a>
|
||||
## 3.3. 另一种 testbench<a id=toc.3.3></a>
|
||||
|
||||
在本小节中,采用另一种 testbench 。与 [3.2 小节](#3.2)中的 testbench 对比,这里有两点不同:
|
||||
在本小节中,采用另一种 testbench 。与 [3.2 小节](#toc.3.2)中的 testbench 对比,这里有两点不同:
|
||||
|
||||
- 写数据源是从文件 `Read_In_File.txt` 中读入的,不再是由 `$random` 系统函数产生的随机数;
|
||||
|
||||
@@ -933,13 +933,13 @@ endmodule
|
||||
读出的地址和数据用系统函数 `$display` 输出到仿真标准输出设备。同时,也将输出数据和地址按照与 `Read_In_File.txt` 文件中一样格式写入到文件 `Write_Out_File. txt` 中,以便于比较。运行仿真以后,在仿真目录下,会生成一个 `Write_Out_File.txt` 文件,用来存储读出的地址和数据。因此只要将这两个文件打开,手动比
|
||||
较,或者利用一些自动比较工具比较,就可以知道仿真结果正确与否。
|
||||
|
||||
关于具体的仿真步骤请参考 [3.2 小节](#3.2)中的操作步骤。工程文件在本文[附带资源][]中的 `Example-7-2` 中。
|
||||
关于具体的仿真步骤请参考 [3.2 小节](#toc.3.2)中的操作步骤。工程文件在本文[附带资源][]中的 `Example-7-2` 中。
|
||||
|
||||
大家将发现,运行完仿真后,在工程目录下会生成一个文件: `Write_Out _File.txt`。可以拿它与文 `Read_In_File.txt` 比较,如果两者一致说明仿真结果正确,否则结果错误。此外,还可以手动查看仿真波形调试问题。
|
||||
|
||||
# 4. 结构化 testbench 思想
|
||||
|
||||
在[第 3 节](#3)中,介绍了两种验证 MPI 模块的 testbench。
|
||||
在[第 3 节](#toc.3)中,介绍了两种验证 MPI 模块的 testbench。
|
||||
|
||||
在这些平台中,在 testbench 的顶层直接描述接口的时序,将测试数据加上去。
|
||||
|
||||
@@ -966,7 +966,7 @@ endmodule
|
||||
|
||||
## 4.1. 任务和函数
|
||||
|
||||
在 [2.1.10 小节](#2.1.10)中,介绍了在 Verilog 中的两种功能封装方法:
|
||||
在 [2.1.10 小节](#toc.2.1.10)中,介绍了在 Verilog 中的两种功能封装方法:
|
||||
|
||||
- 任务:`task`;
|
||||
- 函数:`function`。
|
||||
@@ -977,7 +977,7 @@ endmodule
|
||||
|
||||
BFM 是一种将物理的接口时序操作转化成更高抽象层次接口的总线模型。
|
||||
|
||||
以[第 3 节](#3)中的设计为例,BFM 结构如[图 7-17](#fig.7-17) 所示。
|
||||
以[第 3 节](#toc.3)中的设计为例,BFM 结构如[图 7-17](#fig.7-17) 所示。
|
||||
|
||||
为了验证 FPGA 中 MPI 接口的功能,需要给 MPI 接口加各种各样的激励,仿真激励的种类越多,仿真越完备。
|
||||
|
||||
@@ -1036,7 +1036,7 @@ initial begin
|
||||
end
|
||||
```
|
||||
|
||||
### 4.5.2. 多顶层 testbench<a id=4.5.2></a>
|
||||
### 4.5.2. 多顶层 testbench<a id=toc.4.5.2></a>
|
||||
|
||||
Verilog 语言支持多顶层结构。
|
||||
|
||||
@@ -1081,7 +1081,7 @@ testbench 不是凭空设计的,它的根本起点还是一个设计的需求
|
||||
|
||||
以上重点介绍了结构化 testbench 的思想、基本组成部分和优点。在这里,通过两个实例,从理论到实战过渡。
|
||||
|
||||
## 5.1. 单顶层 testbench<a id=5.1></a>
|
||||
## 5.1. 单顶层 testbench<a id=toc.5.1></a>
|
||||
|
||||
单顶层 testbench 结构如[图 7-29](#fig.7-29) 所示。
|
||||
|
||||
@@ -1193,7 +1193,7 @@ inst_harness.inst_BFM.Write(Data_out, i); // Data_out 为写数据, i 为写
|
||||
inst_harness.inst_BFM.Read(Data_in, i); // Data_in 为读数据, i 为读地址
|
||||
```
|
||||
|
||||
关于具体的仿真步骤请参考 [3.2 小节](#3.2)中的操作步骤。工程文件在本文[附带资源][]中的 `Example-7-3` 目录中。仿真运行结果打印如下:
|
||||
关于具体的仿真步骤请参考 [3.2 小节](#toc.3.2)中的操作步骤。工程文件在本文[附带资源][]中的 `Example-7-3` 目录中。仿真运行结果打印如下:
|
||||
|
||||
``` log
|
||||
# case1, Addr: 0000002f -> DataWrite: 24
|
||||
@@ -1212,7 +1212,7 @@ inst_harness.inst_BFM.Read(Data_in, i); // Data_in 为读数据, i 为读地
|
||||
...
|
||||
```
|
||||
|
||||
这里的 `case1` 就是延用 [3.2 小节](#3.2)中的测试激励,数据源为随机数。而 `case2` 就是 [3.3 小节](#3.3)中的测试激励,数据源是从文件 `Read_In_File.txt` 中读出的。这里将两种数据的测试用例合并到一个文件的不同用例下,检查仿真结果的方法也相同。
|
||||
这里的 `case1` 就是延用 [3.2 小节](#toc.3.2)中的测试激励,数据源为随机数。而 `case2` 就是 [3.3 小节](#toc.3.3)中的测试激励,数据源是从文件 `Read_In_File.txt` 中读出的。这里将两种数据的测试用例合并到一个文件的不同用例下,检查仿真结果的方法也相同。
|
||||
|
||||
## 5.2. 多顶层 testbench
|
||||
|
||||
@@ -1256,26 +1256,26 @@ begin: MYCASE
|
||||
# 222 ;
|
||||
// testcase 1:
|
||||
for ( i=6'b101111; i>= 0; i=i-1 ) begin
|
||||
Data_out = {$random} % 256; //data between 0~255
|
||||
harness.inst_BFM.Write(Data_out, i);
|
||||
$display ("case1, Addr: %h -> DataWrite: %h", i, Data_out);
|
||||
harness.inst_BFM.Read(Data_in, i);
|
||||
$display ("case1, Addr: %h -> DataRead: %h", i, Data_in);
|
||||
$display ("------------------------");
|
||||
end
|
||||
|
||||
$readmemh ( "Read_In_File.txt", DataSource );
|
||||
Write_Out_File = $fopen("Write_Out_File.txt");
|
||||
// testcase 2
|
||||
for ( i=6'b101111; i>= 0; i=i-1 ) begin
|
||||
Data_out = DataSource[i] ;
|
||||
harness.inst_BFM.Write(Data_out, i);
|
||||
$display ("case2, Addr: %h -> DataWrite: %h", i, Data_out);
|
||||
harness.inst_BFM.Read(Data_in, i);
|
||||
$display ("case2, Addr: %h -> DataRead: %h", i, Data_in);
|
||||
$display ("------------------------");
|
||||
$fdisplay (Write_Out_File, "@%h\n%h", i, Data_in);
|
||||
end
|
||||
$fclose ( Write_Out_File );
|
||||
$display ("Simulation Finished!");
|
||||
$stop;
|
||||
@@ -1290,13 +1290,13 @@ endmodule
|
||||
harness.inst_BFM.Write(Data_out, i); // 直接引用 harness 模块名
|
||||
```
|
||||
|
||||
而在 [5.1 小节](#5.1)的单顶层 testbench 中格式如下:
|
||||
而在 [5.1 小节](#toc.5.1)的单顶层 testbench 中格式如下:
|
||||
|
||||
``` verilog
|
||||
inst_harness.inst_BFM.Write(Data_out, i); // 引用 harness 在 testcase 中的实例名: inst_harness
|
||||
```
|
||||
|
||||
具体的仿真步骤请参考 [3.2 小节](#3.2)中的操作步骤。工程文件在本文[附带资源][]中的 `Example-7-4` 目录中。
|
||||
具体的仿真步骤请参考 [3.2 小节](#toc.3.2)中的操作步骤。工程文件在本文[附带资源][]中的 `Example-7-4` 目录中。
|
||||
|
||||
# 6. 扩展 Verilog 的高层建模能力
|
||||
|
||||
@@ -1322,6 +1322,6 @@ inst_harness.inst_BFM.Write(Data_out, i); // 引用 harness 在 testcase 中的
|
||||
|
||||
EDA 先锋工作室. *轻松成为设计高手——Verilog HDL 实用精解.* 北京航空航天大学出版社, 2012.
|
||||
|
||||
[《Part 3——描述方式和设计层次》的 5.1 小节]: https://josh-gao.top/posts/fd117896.html#5.1
|
||||
[Part 3——描述方式和设计层次的 5.1 系统级和行为级]: https://josh-gao.top/posts/fd117896.html#toc.5.1
|
||||
[《Josh 的学习笔记之 Verilog》]: https://josh-gao.top/categories/Josh-%E7%9A%84%E5%AD%A6%E4%B9%A0%E7%AC%94%E8%AE%B0/Verilog/
|
||||
[附带资源]: https://download.csdn.net/download/weixin_43870101/12451000
|
||||
|
||||
Reference in New Issue
Block a user