update dependency, move pics from tencent cloud to local repo
This commit is contained in:

@@ -87,7 +87,7 @@ WCDMA(宽带码分多址)系统中使用到了快速哈达码(Fast Hadamar
|
||||
|
||||
<a id="fig.5-1"></a>
|
||||
|
||||
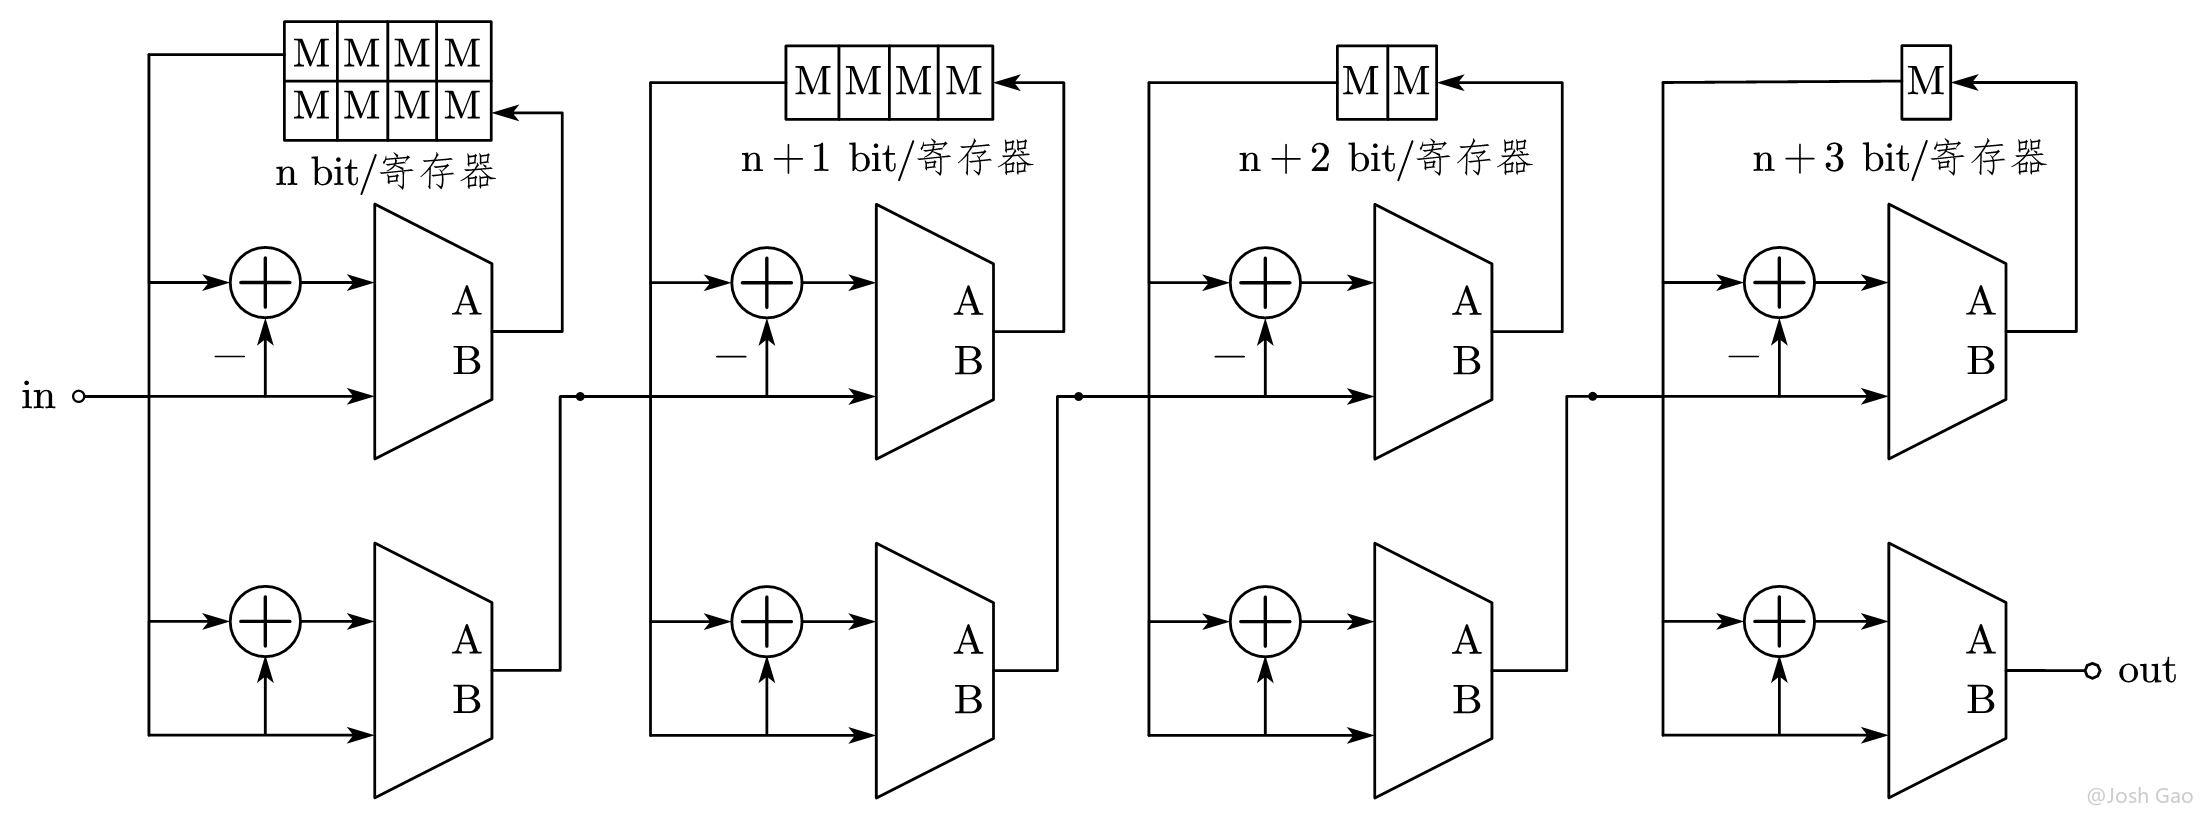{width=1000px}
|
||||
{width=1000px}
|
||||
|
||||
FHT 单步算法如下:
|
||||
|
||||
@@ -258,7 +258,7 @@ endmodule
|
||||
|
||||
<a id="fig.5-2"></a>
|
||||
|
||||
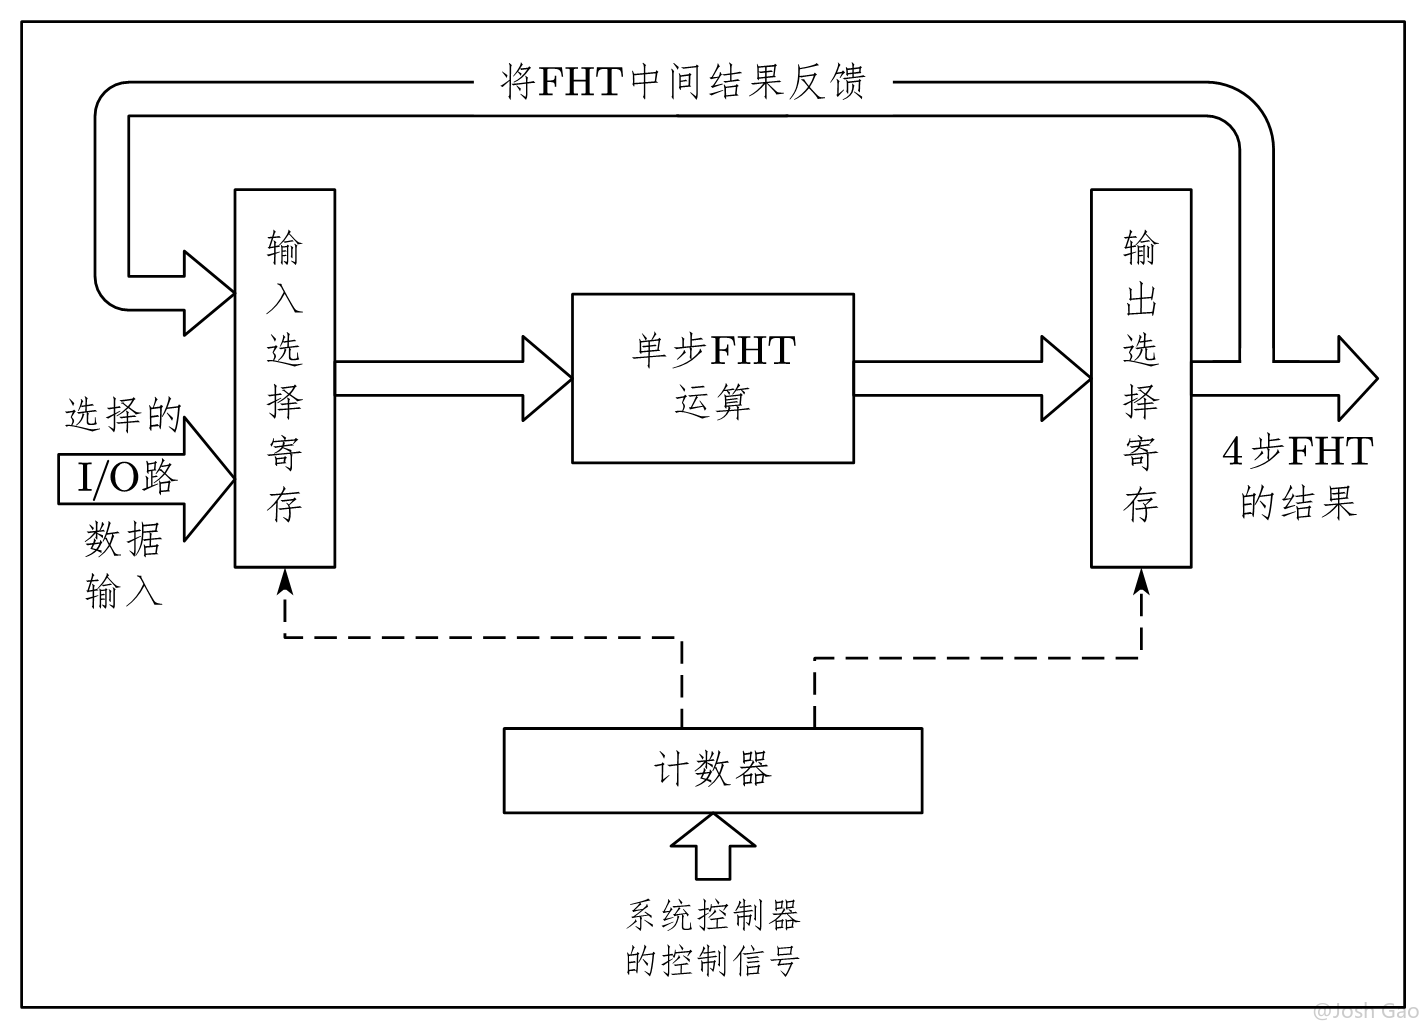{width=600px}
|
||||
{width=600px}
|
||||
|
||||
代码如下:
|
||||
|
||||
@@ -373,11 +373,11 @@ endmodule
|
||||
|
||||
<a id="fig.5-3"></a>
|
||||
|
||||
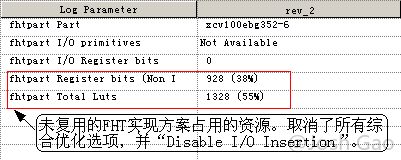
|
||||

|
||||
|
||||
<a id="fig.5-4"></a>
|
||||
|
||||
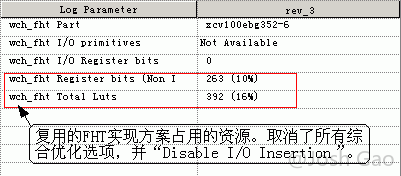
|
||||

|
||||
|
||||
通过对比可以清晰地观察到,采用复用实现方案所占面积约为原方案的 1/4,而得到这个好处的代价是,完成整个 FHT 运算的周期为原来的 4 倍。这个例子通过运算周期的加长,换取了消耗芯片面积的减少,是前面所述的用频率换面积的一种体现。本例所述“频率换面积”的前提是,FHT 模块频率较高,运算周期的余量较大,采用 4 步复用后,仍然能够满足系统流水线设计的要求。其实,如果流水线时序允许,FHT 运算甚至可以采用 1 bit 串行方案实现,该方案所消耗的芯片面积资源更少!
|
||||
|
||||
@@ -389,7 +389,7 @@ endmodule
|
||||
|
||||
<a id="fig.5-5"></a>
|
||||
|
||||
{width=700px}
|
||||
{width=700px}
|
||||
|
||||
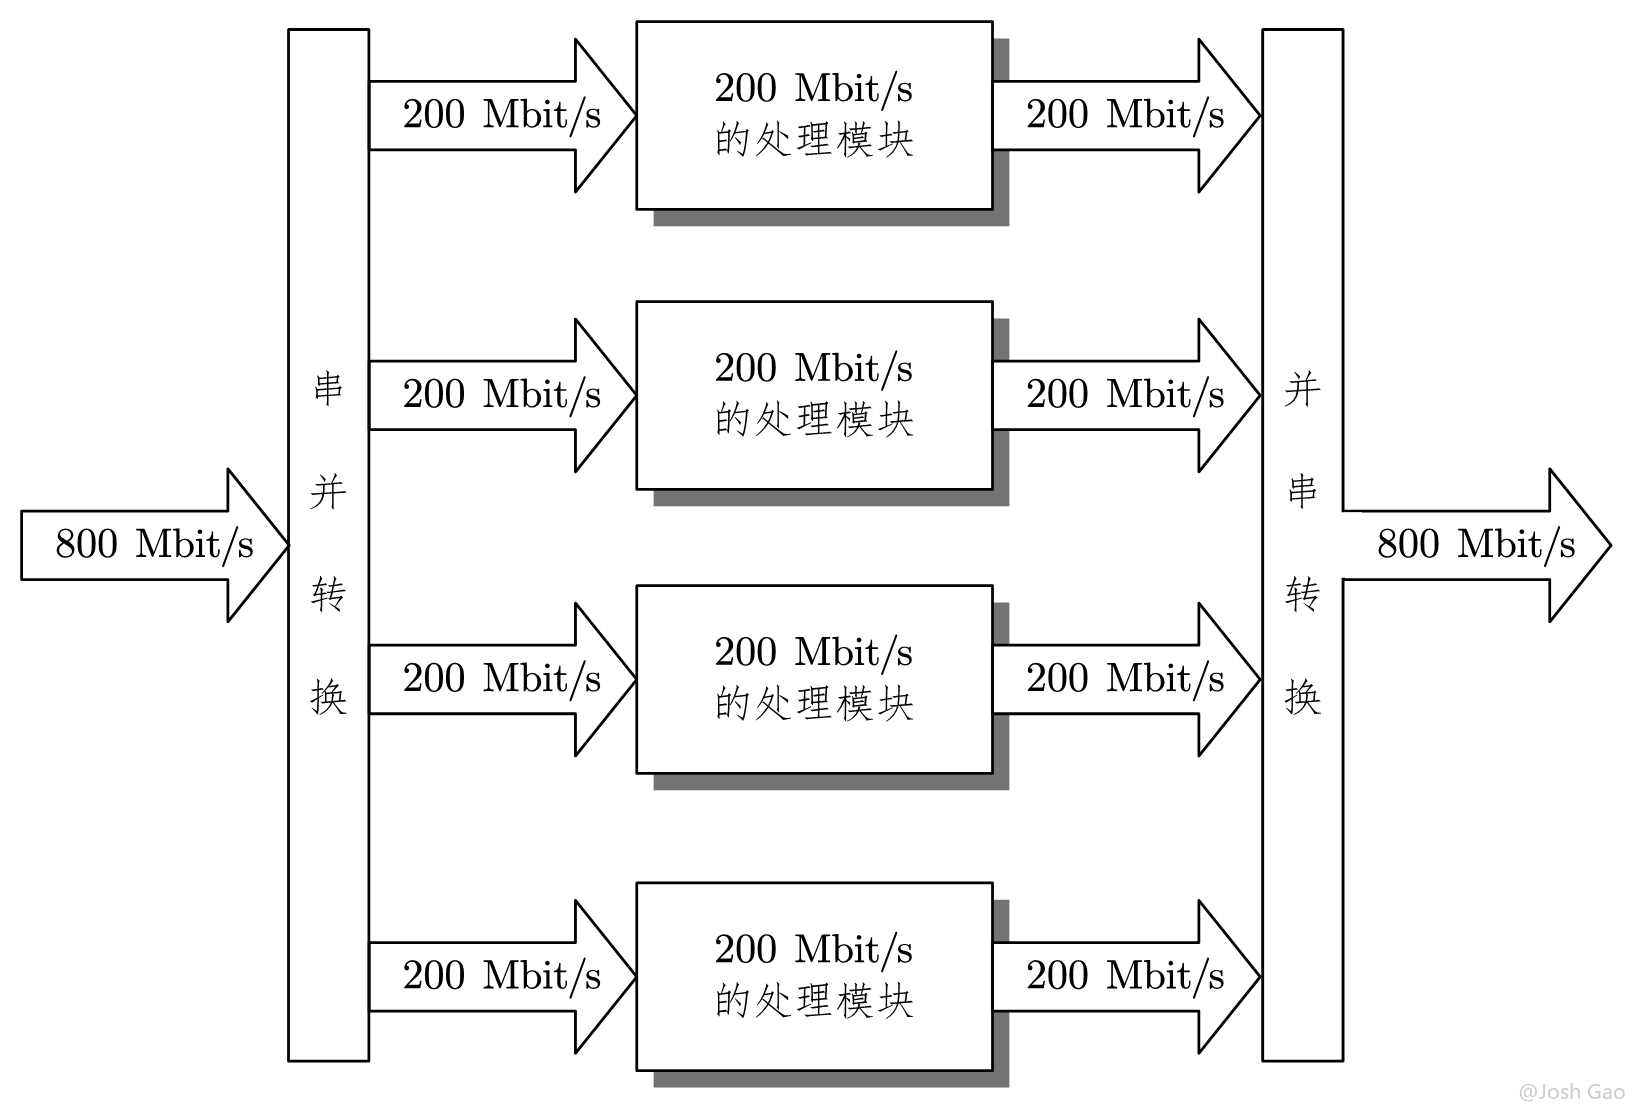
“面积复制换取速度提高”或者说“面积复制换取数据吞吐量的提高”是目前 FPGA 设计的常用技巧之一。现代高速FPGA 基本都有 DDR/DDR2/DDR3 的 I/O 硬件电路,通过这种 I/O 硬件电路,可以实现输入数据流的 1:2 和 1:4 的串/并变换和并/串变换,很多中高端 FPGA 在 I/O BANK 附近还专门设计了硬件的 DLL 或 PLL,配合 DDR/DDR2/DDR3 的 I/O 硬件电路完成对应的采样时钟的降速和倍速。调用这些 I/O 的硬件模块,可以方便、可靠地实现数据流的并行化(输入端)和串行化(输出端),从而更利于实现“面积复制换取速度提高”,或“面积复制换取数据吞吐量的提高”的设计思想。
|
||||
|
||||
@@ -495,7 +495,7 @@ case (var)
|
||||
|
||||
<a id="fig.5-6"></a>
|
||||
|
||||
{width=700px}
|
||||
{width=700px}
|
||||
|
||||
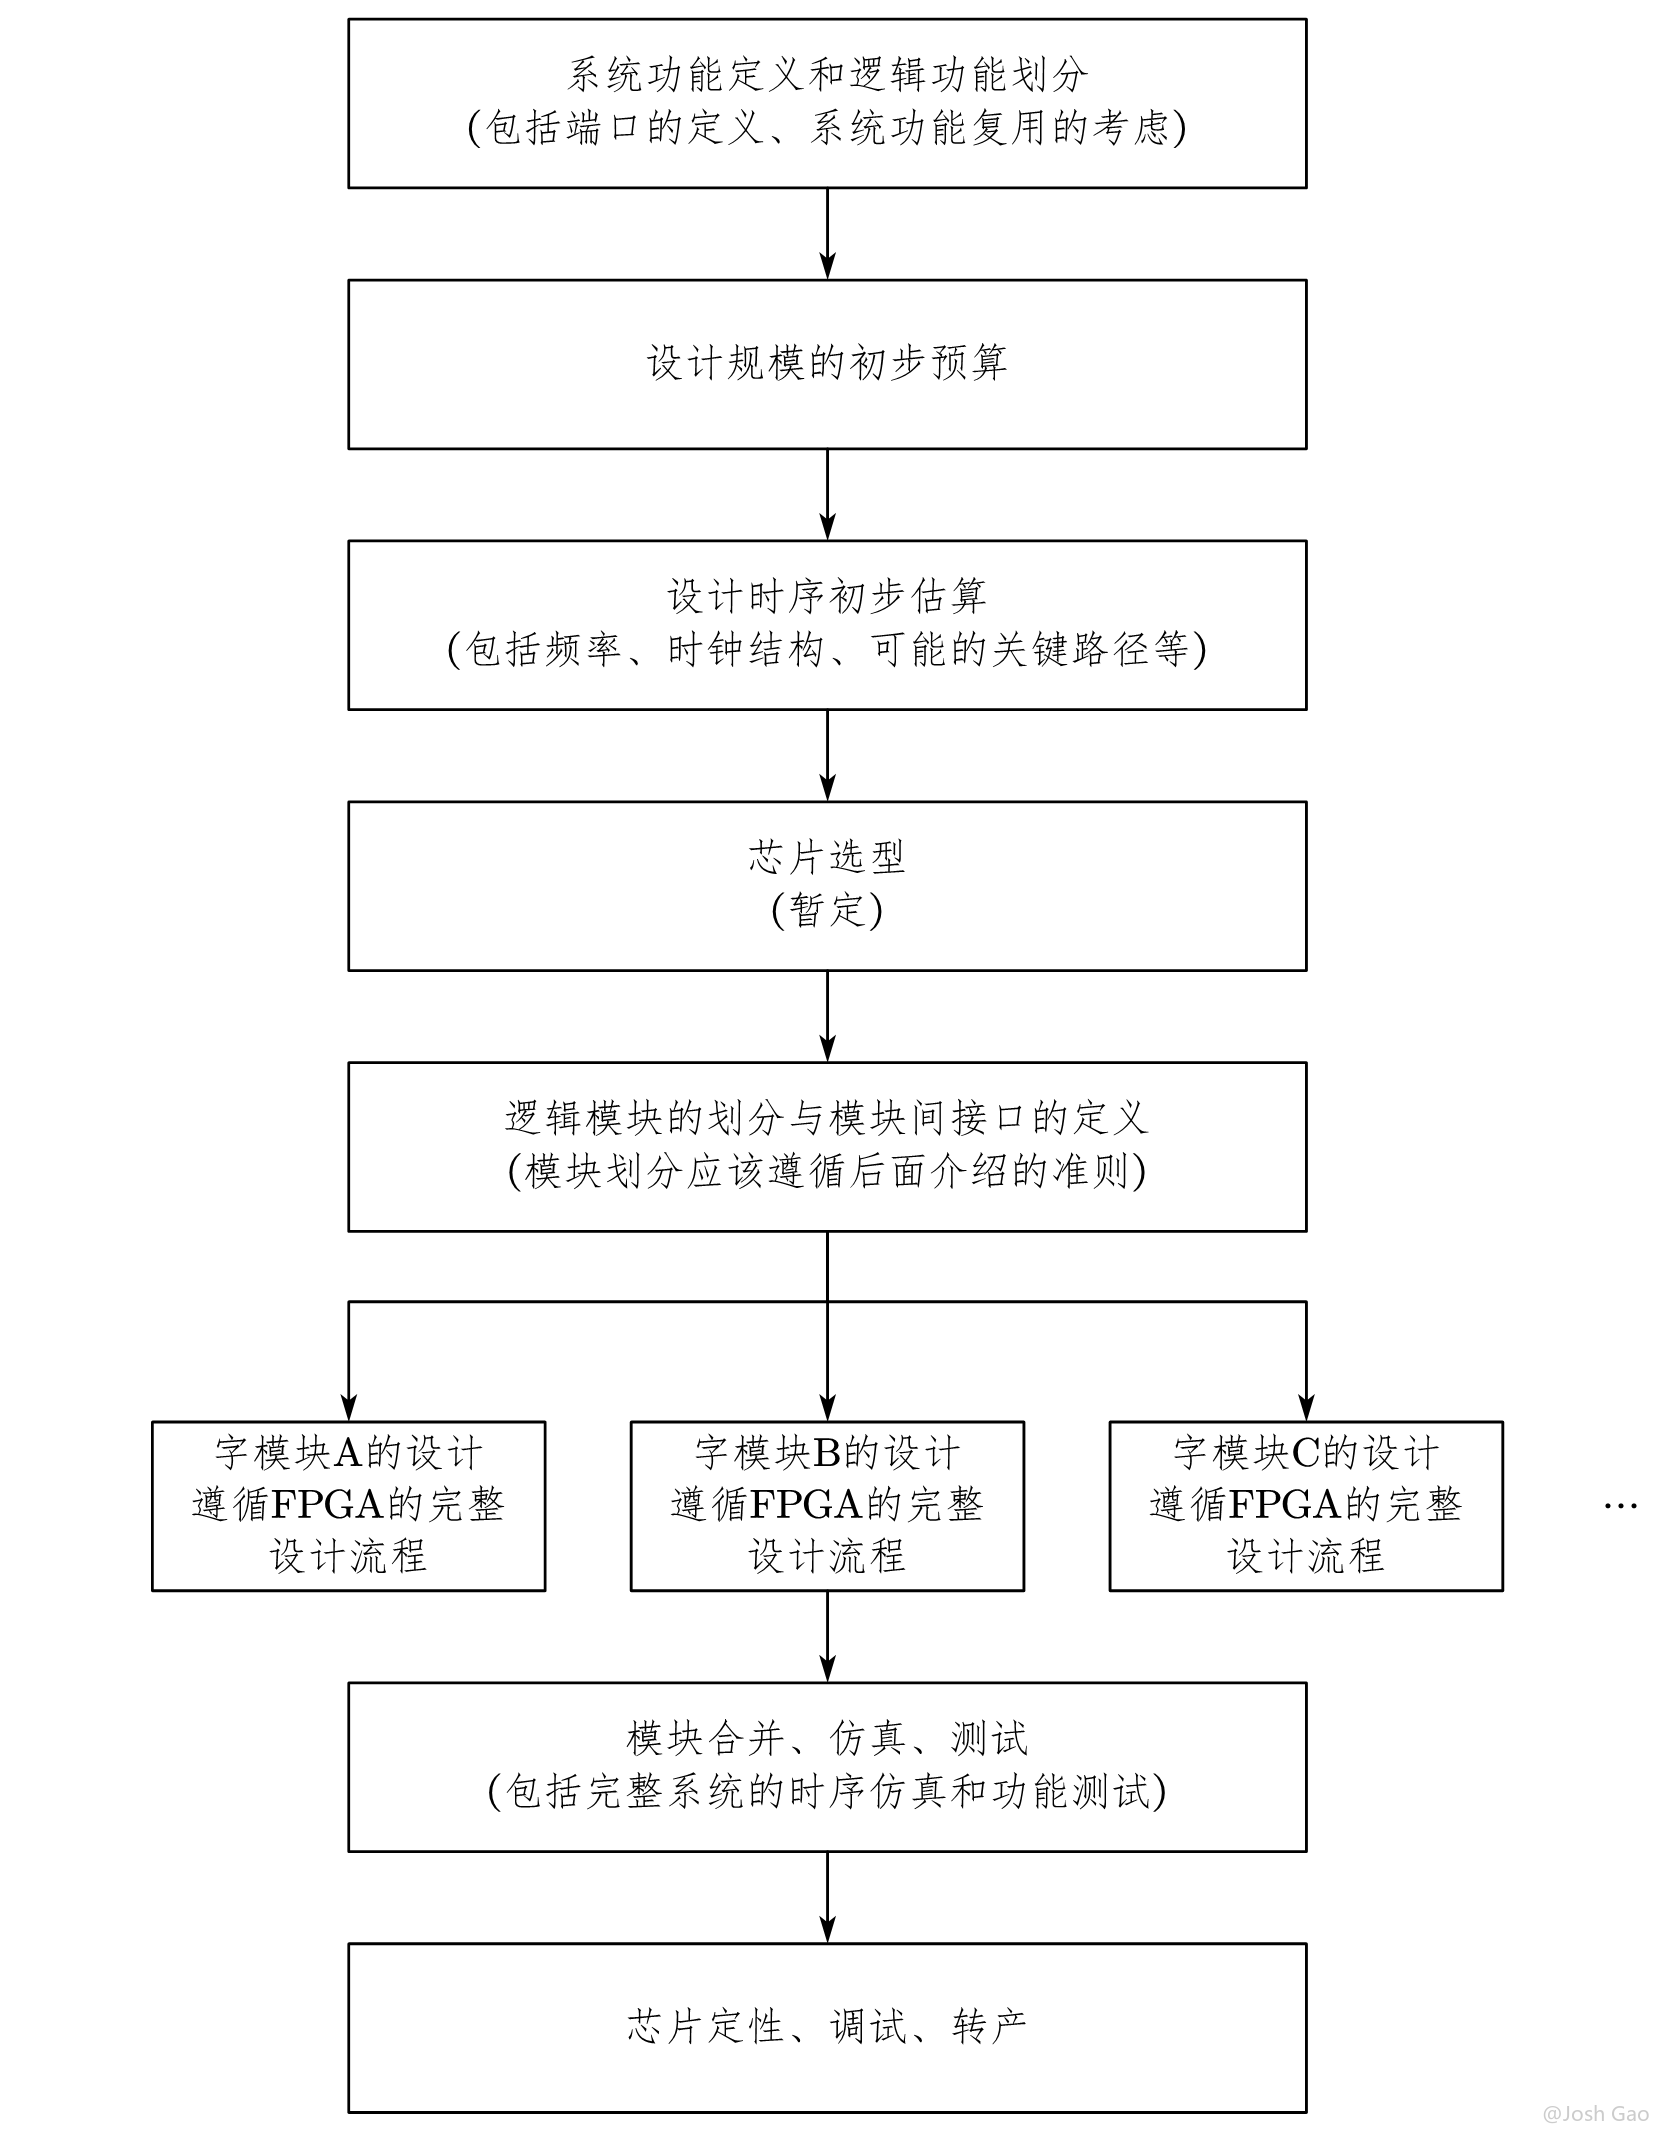
对系统原则做一点引申,简单谈谈模块化设计方法。模块化设计是系统原则的一个很好的体现,它不仅是一种设计工具,它更是一种设计思路、设计方法,它是由顶向下、模块划分、分工协作设计思路的集中体现,是当代大型复杂系统的推荐设计方法。目前很多的 EDA 厂商都提高了模块化设计工具,通过这类工具划分每个模块的设计区域,然后单独设计和优化每个模块,最后将每个模块融合到顶层设计中,从而实现了团队协作、并行设计的模块化设计方法。合理使用模块化设计方法,能在最大程度上继承以往设计成果,并行分工协作,有效利用开发资源,缩短开发周期。
|
||||
|
||||
@@ -505,7 +505,7 @@ case (var)
|
||||
|
||||
<a id="fig.5-7"></a>
|
||||
|
||||
{width=600px}
|
||||
{width=600px}
|
||||
|
||||
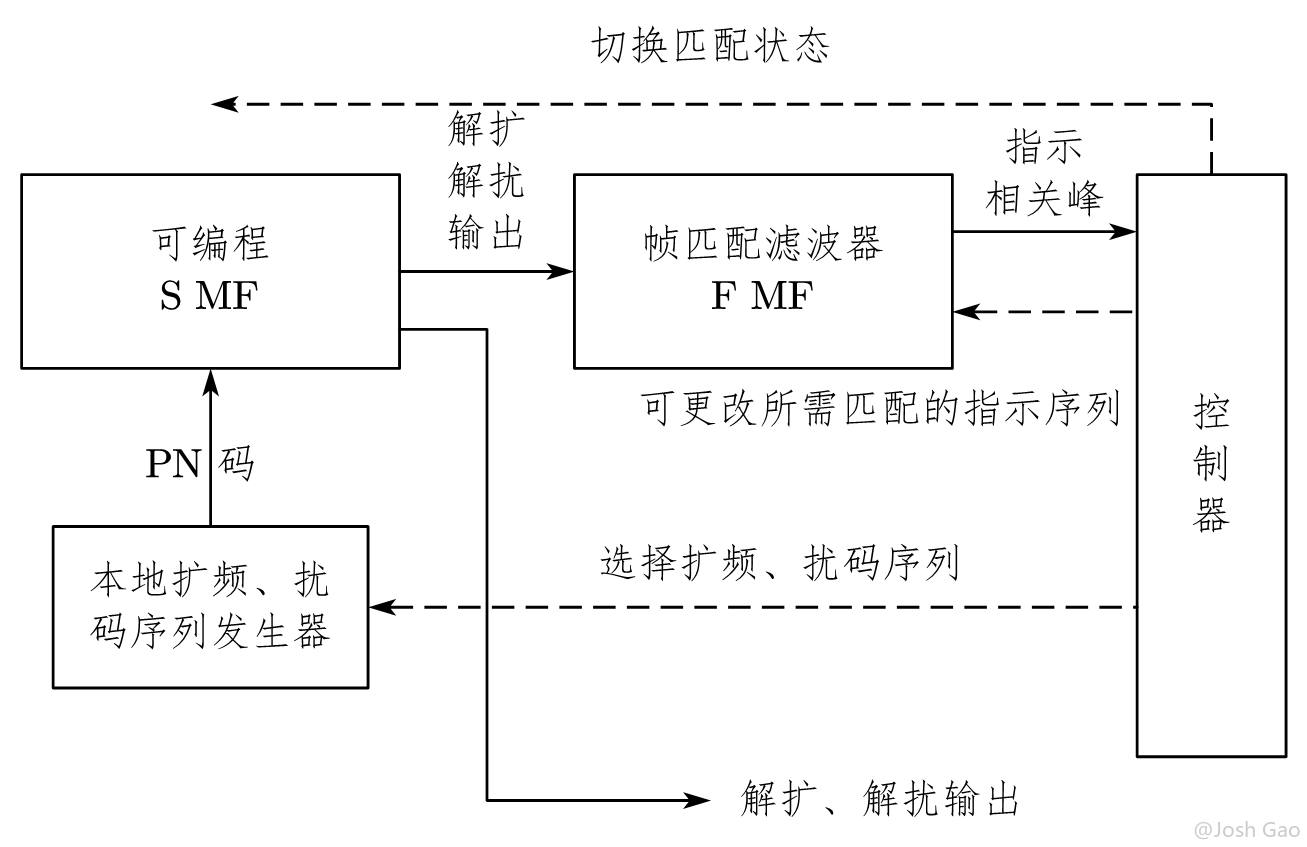
其设计思想是:利用信道固有特点(如信道 pilot 导频、信道结构等),应用现代可编程数字信号处理的技术(如 DSP、FPGA 等),采取反馈与控制匹配滤波方式,实现对某信道的已扩信息的自动解扩解扰。该可编程 MF 的主要组成部分为本地码发生器、可编程信号 MF(S MF)、帧匹配滤波器(FRAME MF)和控制器。本地码发生器可生成各种所需的扩频、加扰序列,可接收控制器的指示脉冲,产生规定的本地解扩、解扰序列,作为 S MF 的参考序列;S MF 是完成匹配滤波的主体,可接收控制器的指示脉冲,将自己的匹配状态切换到下一匹配状态;FMF 完成对导频信号等特殊信号(信息位待选集有限)的检测,生成指示相关峰,通知控制器将 SMF 切换到下一匹配状态;控制器统一协调各部分工作。这种可编程滤波器可以在如越区切换、同步方面、CPCH 收发信机等多方面应用,如果适当安排时序流程,可以在较大程度上节约硬件资源。
|
||||
|
||||
@@ -565,7 +565,7 @@ case (var)
|
||||
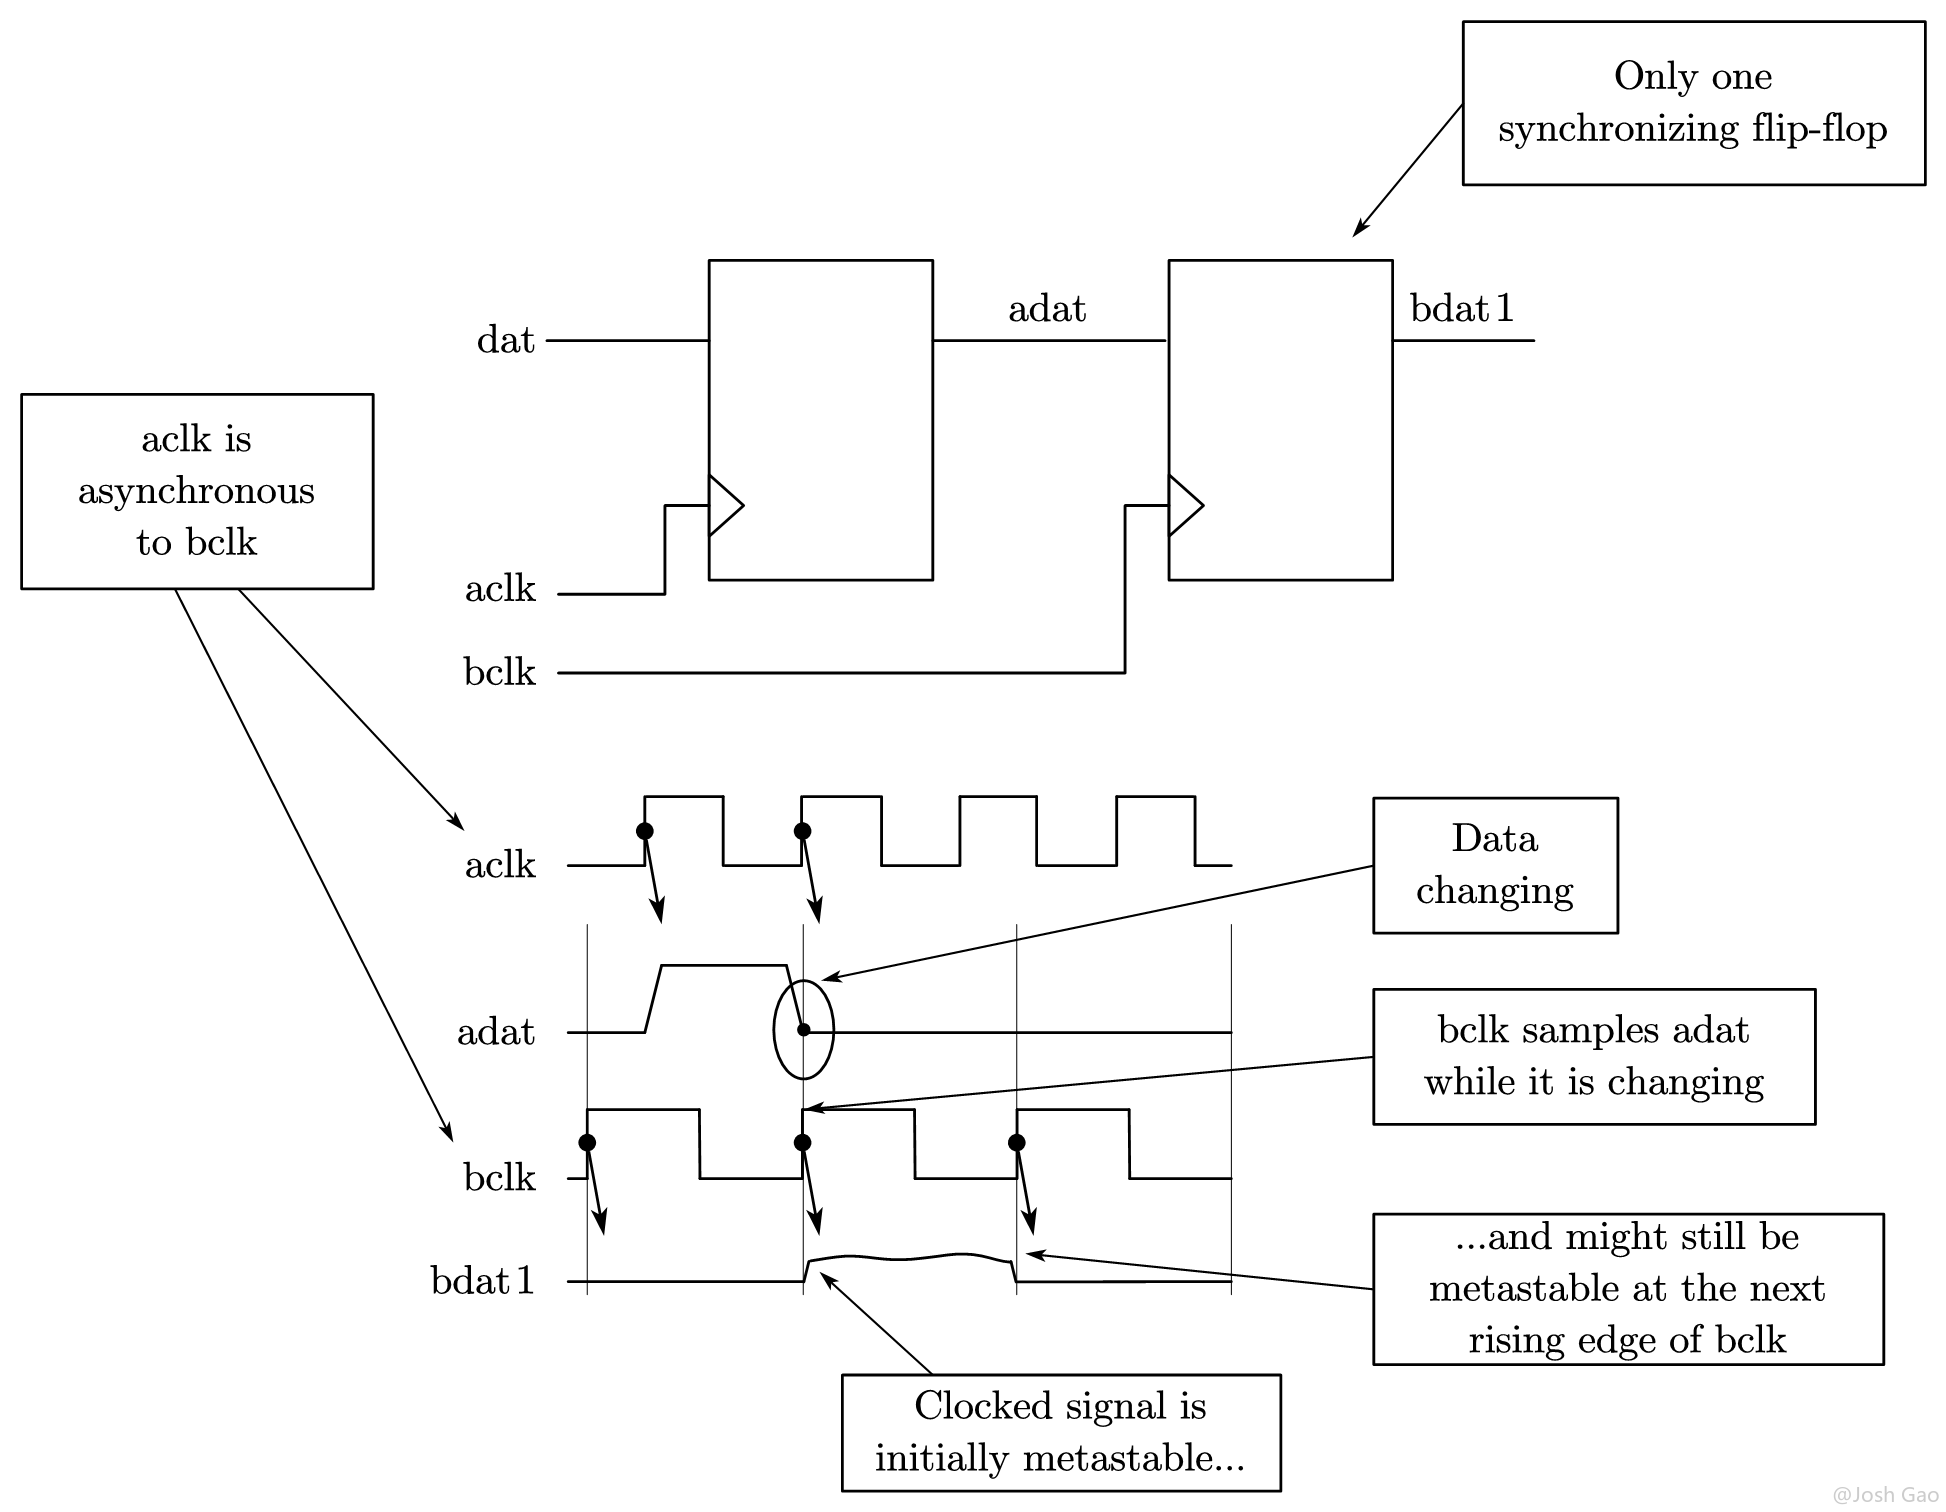
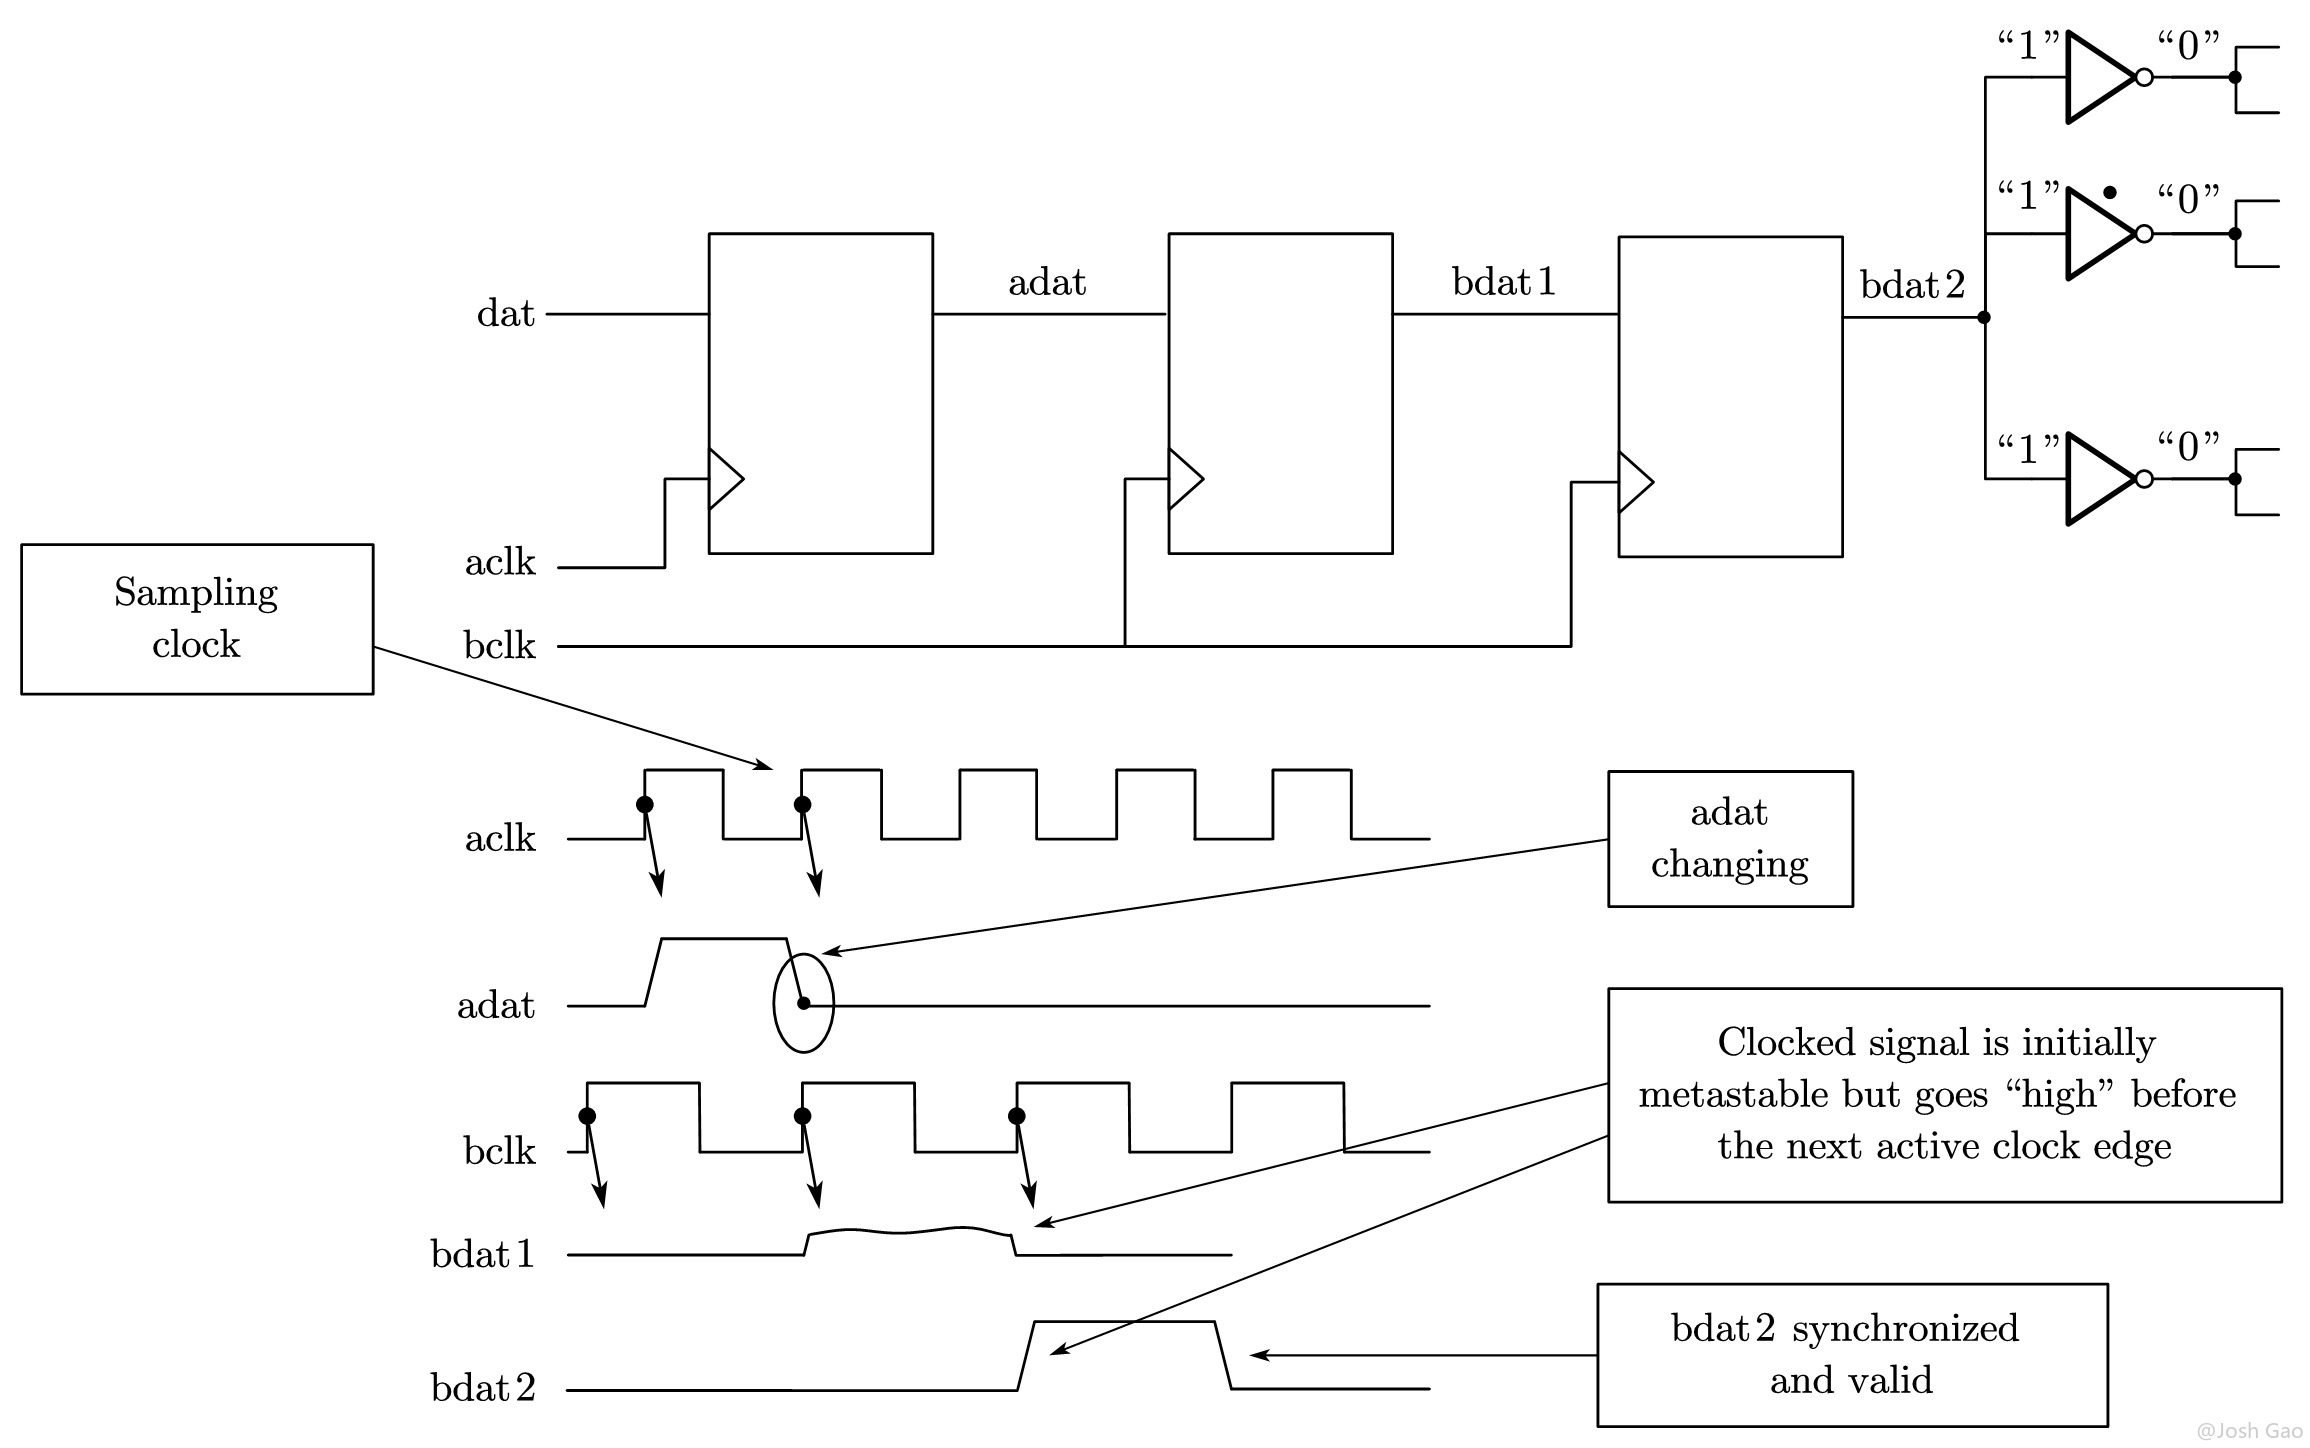
异步时钟域的转换的核心就是要保证下级时钟对上级数据采样的 Setup 时间和 Hold 时间。如果触发器的Setup 时间或者 Hold 时间不满足,就可能产生亚稳态,**此时触发器输出端 Q 在有效时钟沿之后比较长的一段时间内处于不确定的状态,在这段时间内 Q 端产生毛刺并不断振荡,最终固定在某一电压值,此电压值并不一定等于原来数据输入端 D 的数值**,这段时间称为决断时间(Resolution time)。经过 Resolution time 之后 Q 端将稳定到 0 或1, 但是究竟是 0 还是1,这是随机的,与输入没有必然的关系,其产生示意图如[图 5-8](#fig.5-8) 所示。
|
||||
|
||||
<a id="fig.5-8"></a>
|
||||
{width=800px}
|
||||
{width=800px}
|
||||
|
||||
**亚稳态的危害主要体现在破坏系统的稳定性**。由于输出在稳定下来之前可能是毛刺、振荡、固定的某一电压值,因此亚稳态将**导致逻辑误判**,严重情况下输出 0~1 之间的中间电压值还会**使下一级产生亚稳态,即导致亚稳态的传播**。逻辑误判导致功能性错误,而亚稳态的传播则扩大了故障面。另外,在亚稳态状态下,任何诸如环境噪声、电源于扰等细微扰动都将导致更恶劣的状态不稳定。这时这个系统的传输延迟增大,状态输出错误,在某些情况下甚至会使寄存器在两个有效判定门限($\mathrm{V_{oL}}$ 、$\mathrm{V_{oH}}$)之间长时间的振荡。
|
||||
|
||||
@@ -575,7 +575,7 @@ case (var)
|
||||
|
||||
<a id="fig.5-9"></a>
|
||||
|
||||
{width=800px}
|
||||
{width=800px}
|
||||
|
||||
使用[图 5-9](#fig.5-9) 两级寄存器采样仅能降低亚稳态的概率,但是并不能保证第二级输出的稳态电平就是正确电平。前面说过经过 Resolution time 之后寄存器输出的电平是一个不确定的稳态值,也就是说**这种处理方法并不能排除采样错误的产生**,这时就**要求所设计的系统对采样错误有一定的容忍度**。有些应用本身就对采样错误不敏感,如一帧图像编码,一段话音编码等。而有些系统对错误采样比较敏感。这类由于亚稳态造成的采样是一些突发的错误,所以可以采用一些纠错编码手段完成错误的纠正。
|
||||
|
||||
@@ -632,7 +632,7 @@ case (var)
|
||||
|
||||
<a id="fig.5-10"></a>
|
||||
|
||||
{width=800px}
|
||||
{width=800px}
|
||||
|
||||
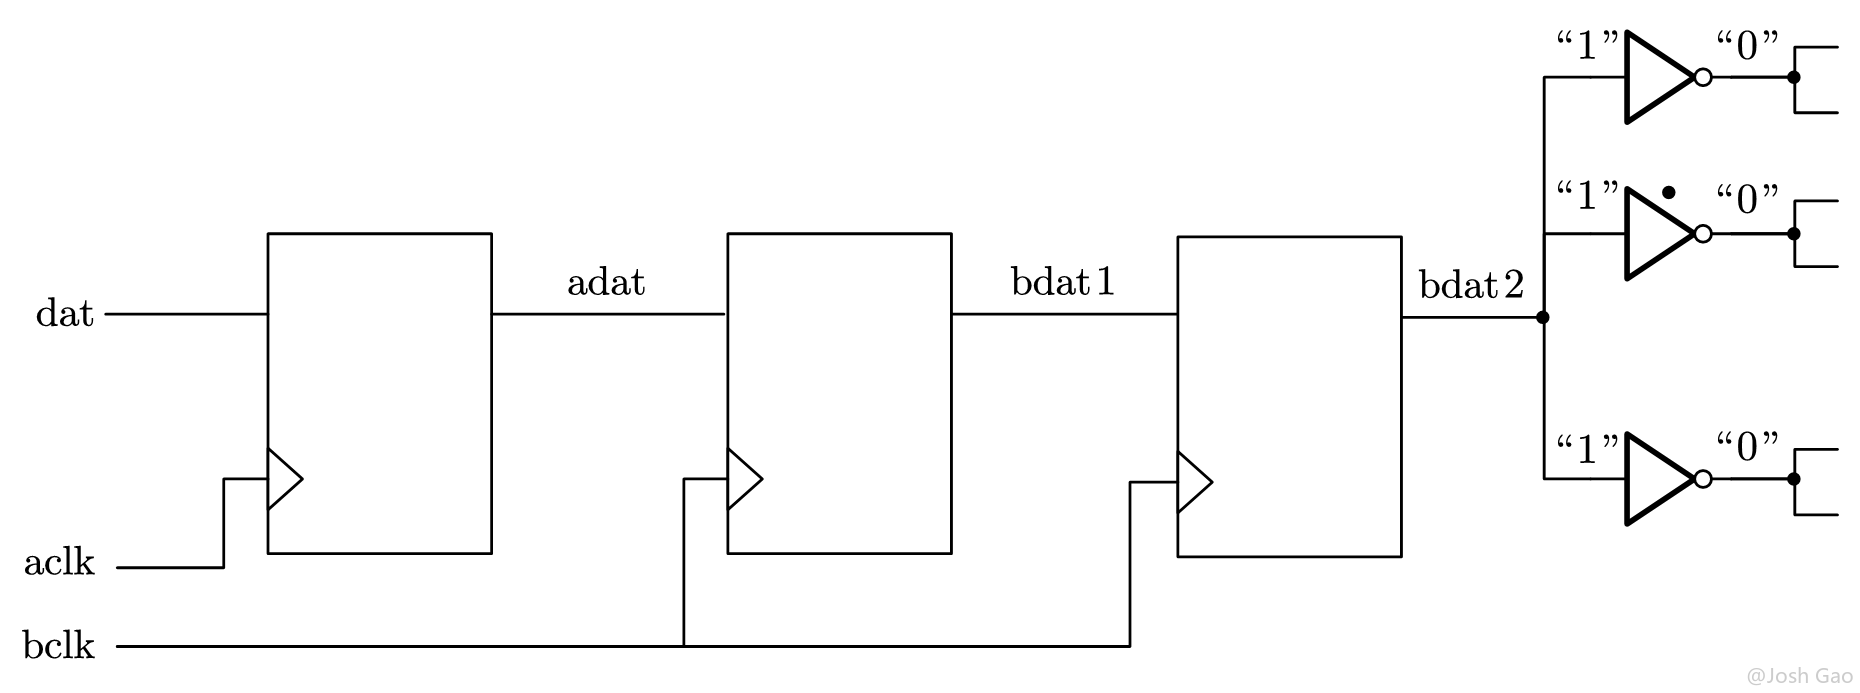
可靠的做法是用 DPRAM 、FIFO 或者一段寄存器 Buffer 完成异步时钟域的数据转换。把数据存放在 DPRAM 或FIFO 的方法如下:将上级芯片提供的数据随路时钟作为写信号,将数据写入 DPRAM 或者FIFO, 然后使用本级的采样时钟( 一般是数据处理的主时钟),将数据读出即可。由于时钟频率相同,所以 DPRAM 或 FIFO 两端的数据吞吐率一致,实现起来相对简单。
|
||||
|
||||
@@ -668,7 +668,7 @@ case (var)
|
||||
|
||||
<a id="fig.5-11"></a>
|
||||
|
||||
{width=600px}
|
||||
{width=600px}
|
||||
|
||||
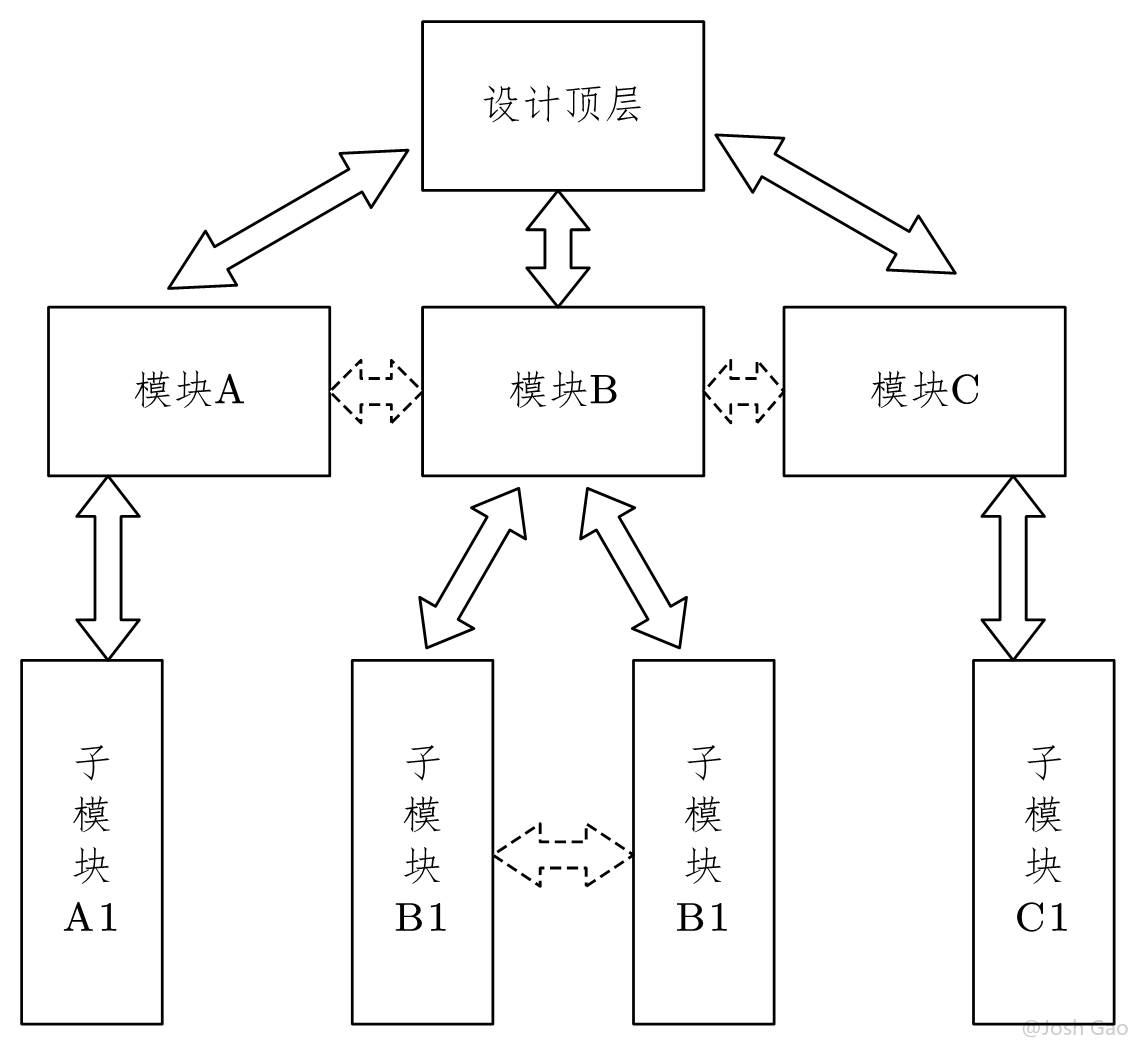
结构层次化编码有如下注意事项:
|
||||
|
||||
@@ -744,7 +744,7 @@ case (var)
|
||||
|
||||
<a id="fig.5-12"></a>
|
||||
|
||||
{width="400px"}
|
||||
{width="400px"}
|
||||
|
||||
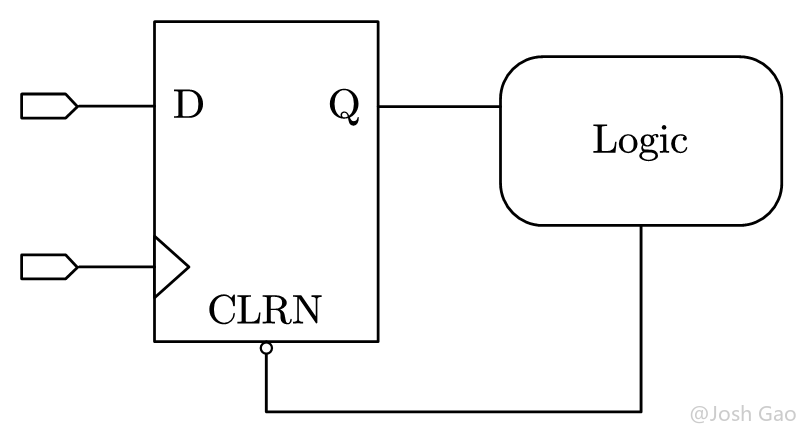
组合逻辑反馈环路是一种**高风险**设计方式,主要原因如下:
|
||||
|
||||
@@ -764,7 +764,7 @@ case (var)
|
||||
|
||||
<a id="fig.5-13"></a>
|
||||
|
||||
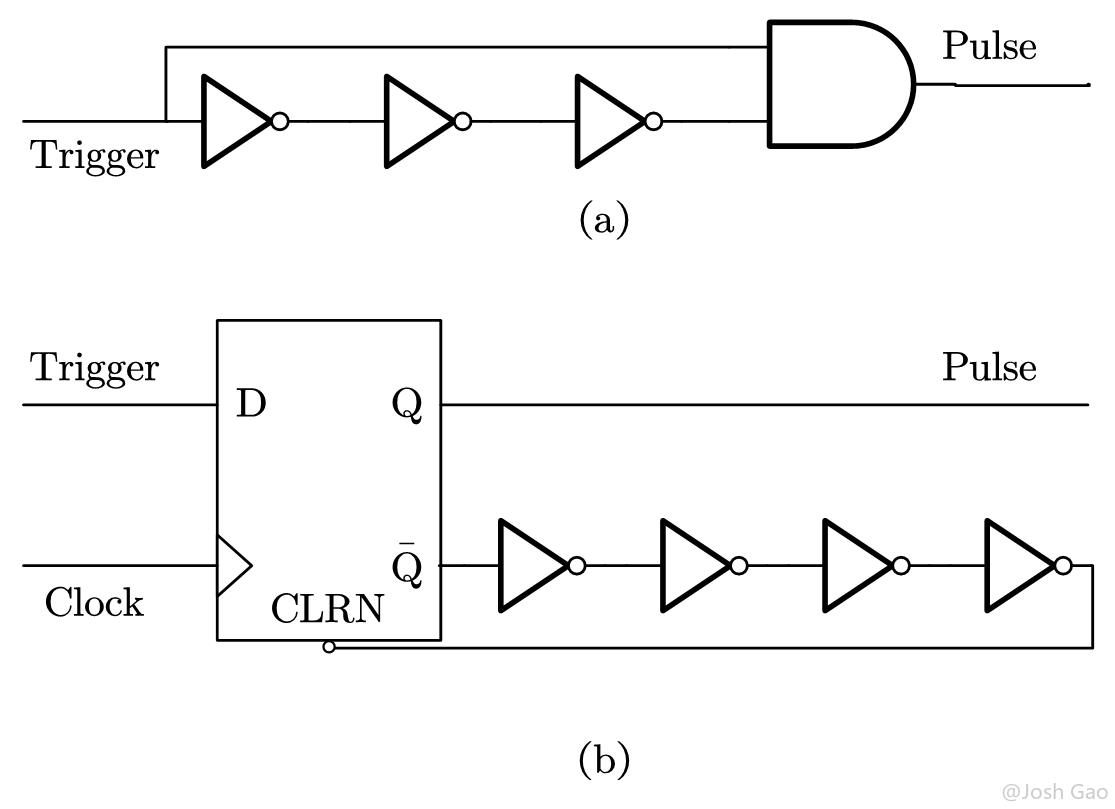{width=600px}
|
||||
{width=600px}
|
||||
|
||||
这类异步方法设计的脉冲产生电路的脉冲宽度取决于 Delay Chains 的门延迟和线延迟,而在 FPGA/CPLD 中,大多数 Timing Driven 的综合、布线工具无法保证其布线延迟恒定。另外,PLD 器件本身在不同的 PVT(工艺、电压、温度)环境下其延时参数也有微小波动,所以脉冲宽度无法准确确定。而且 STA 工具也无法准确分析脉冲的特性,为时序仿真和验证带来了很多的不确定性。
|
||||
|
||||
@@ -774,7 +774,7 @@ case (var)
|
||||
|
||||
<a id="fig.5-14"></a>
|
||||
|
||||
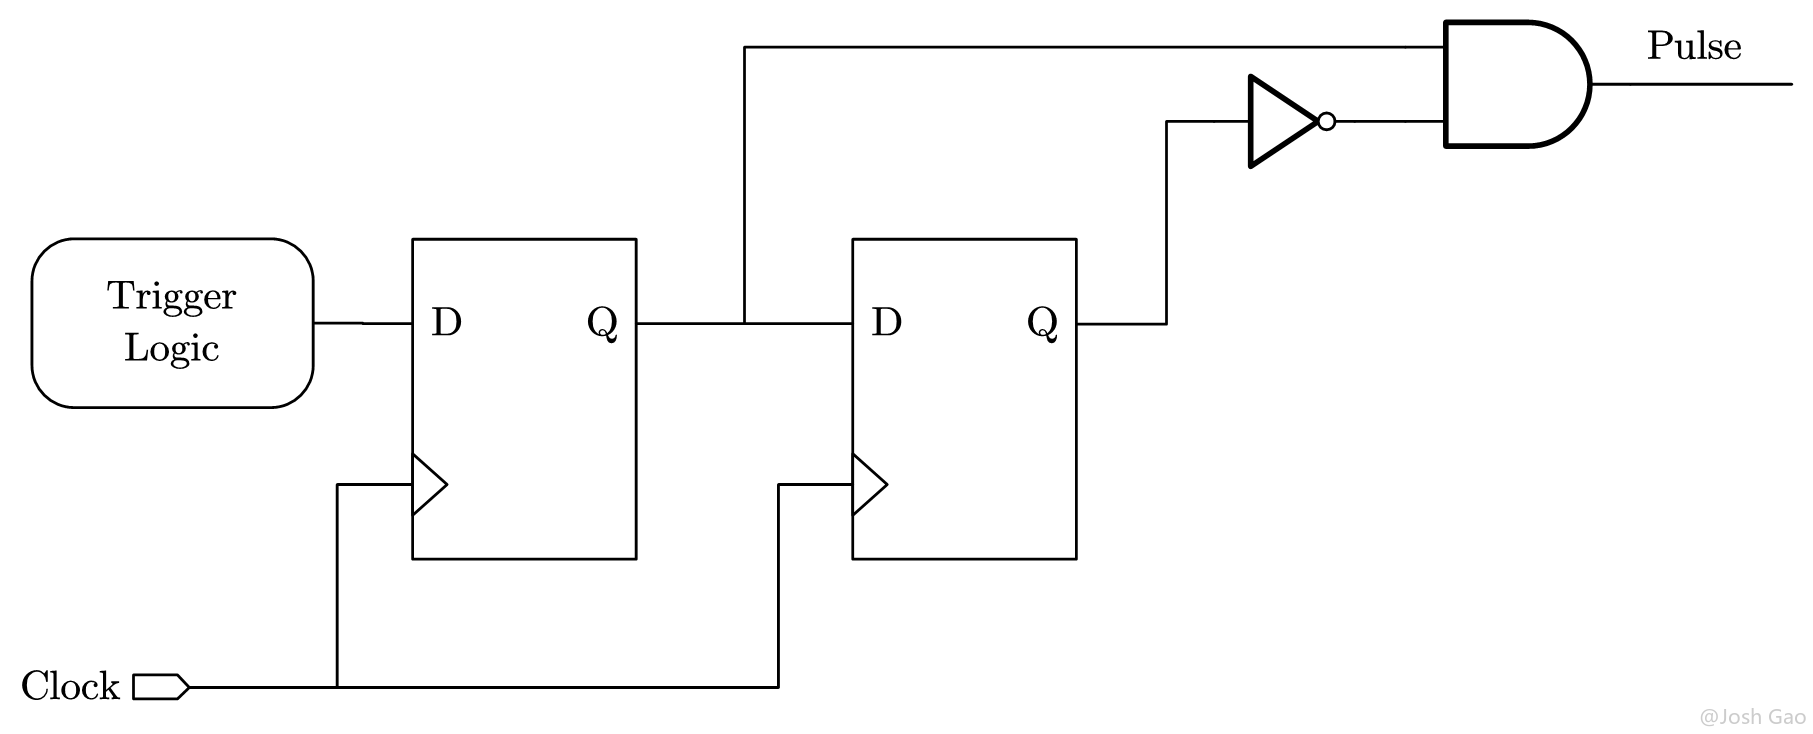{width=600px}
|
||||
{width=600px}
|
||||
|
||||
## 5.4. 慎用锁存器
|
||||
|
||||
@@ -807,7 +807,7 @@ endmodule
|
||||
|
||||
<a id="fig.5-15"></a>
|
||||
|
||||
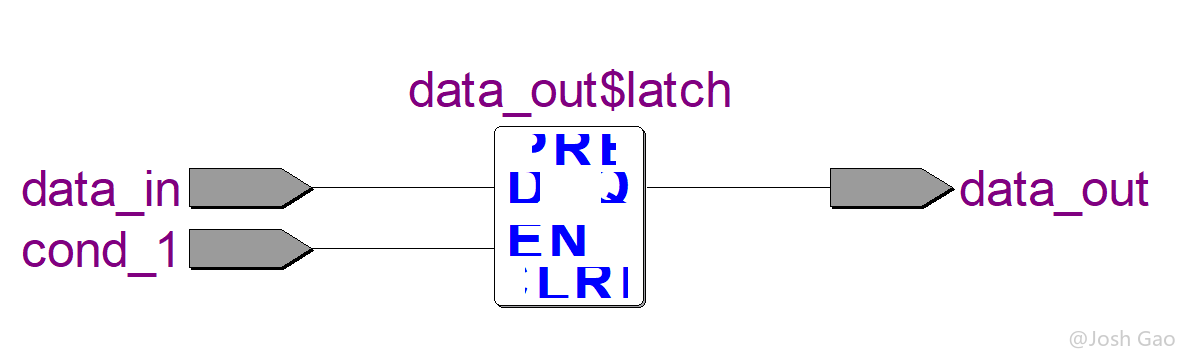{width=500px}
|
||||
{width=500px}
|
||||
|
||||
防止产生非目的性的Latch 的措施如下:
|
||||
|
||||
@@ -832,7 +832,7 @@ endmodule
|
||||
|
||||
<a id="fig.5-16"></a>
|
||||
|
||||
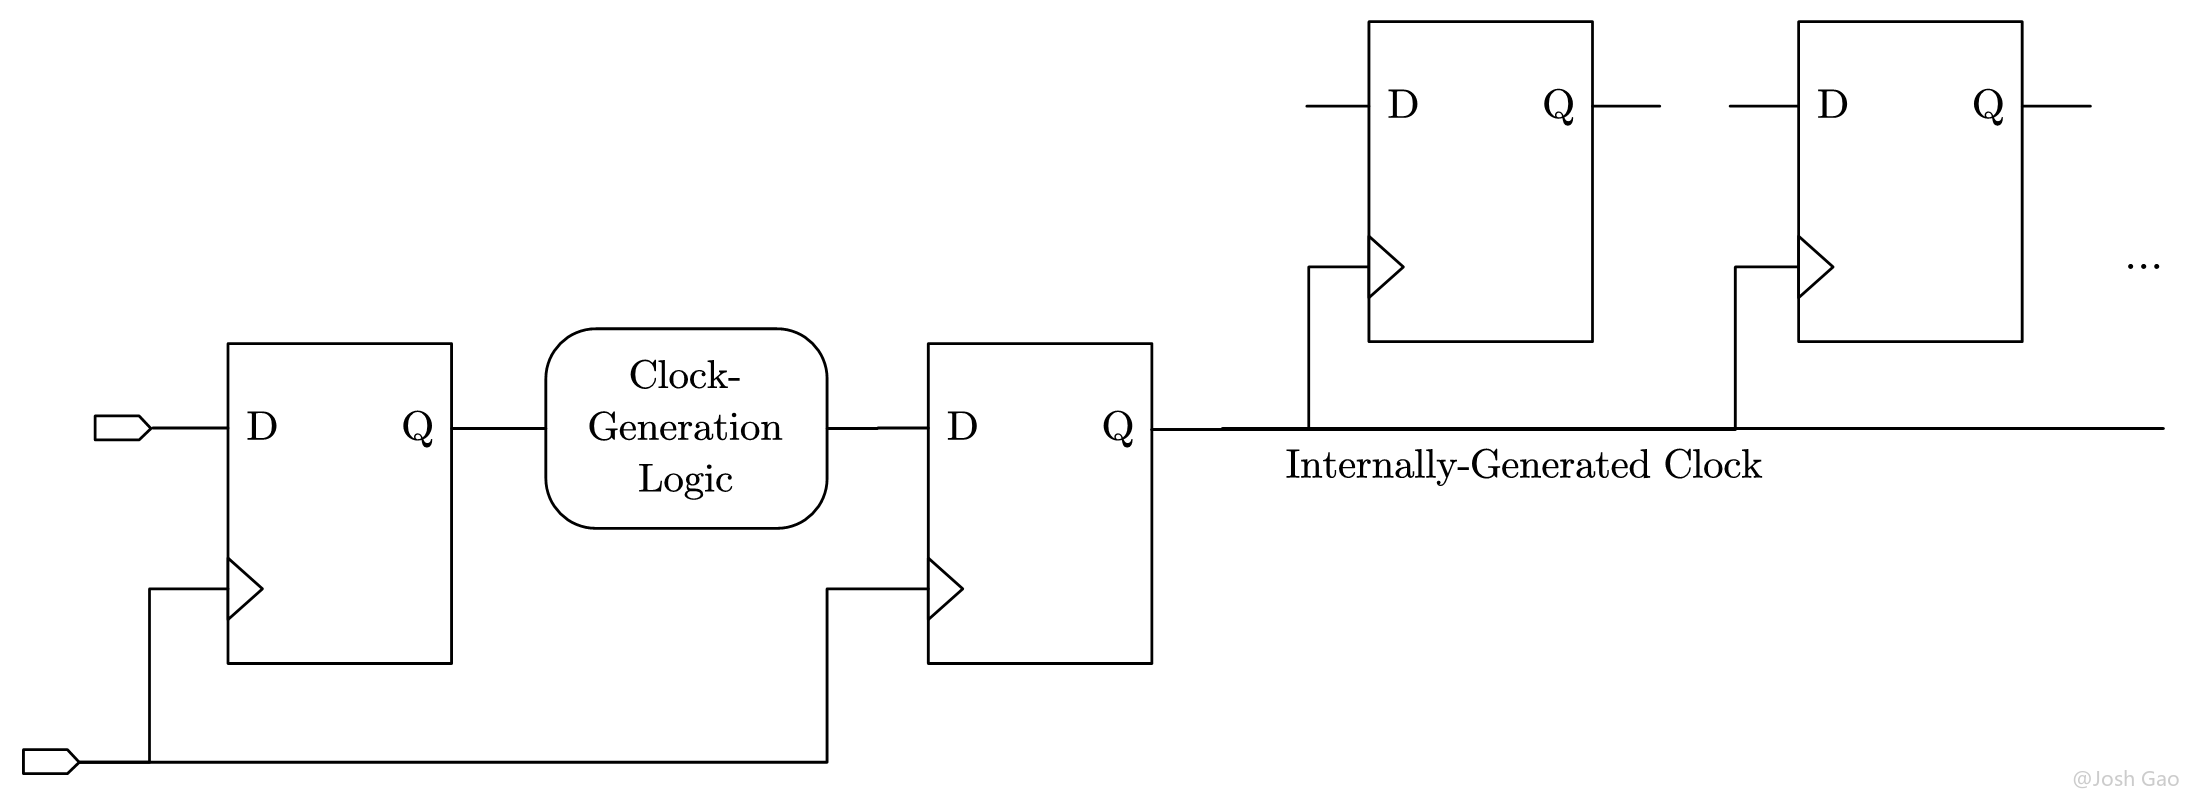{width=800px}
|
||||
{width=800px}
|
||||
|
||||
另一方面,组合逻辑产生的时钟还会带来另外一个问题,组合逻辑电路的 Jitter 和 Skew 都比较大,如果时钟产生逻辑的延迟比数据路径的延迟更大,会带来负的 Skew,负的 Skew 同步逻辑设计是灾难性的。所以**使用组合逻辑产生内部时钟仅适用于时钟频率较低、时钟精度要求不高的情况**。另外,**这类时钟应该使用快速布线资源布线,而且需要对组合逻辑电路附加一定的约束条件,以确保时钟质质量**。
|
||||
|
||||
@@ -856,7 +856,7 @@ endmodule
|
||||
|
||||
<a id="fig.5-17"></a>
|
||||
|
||||
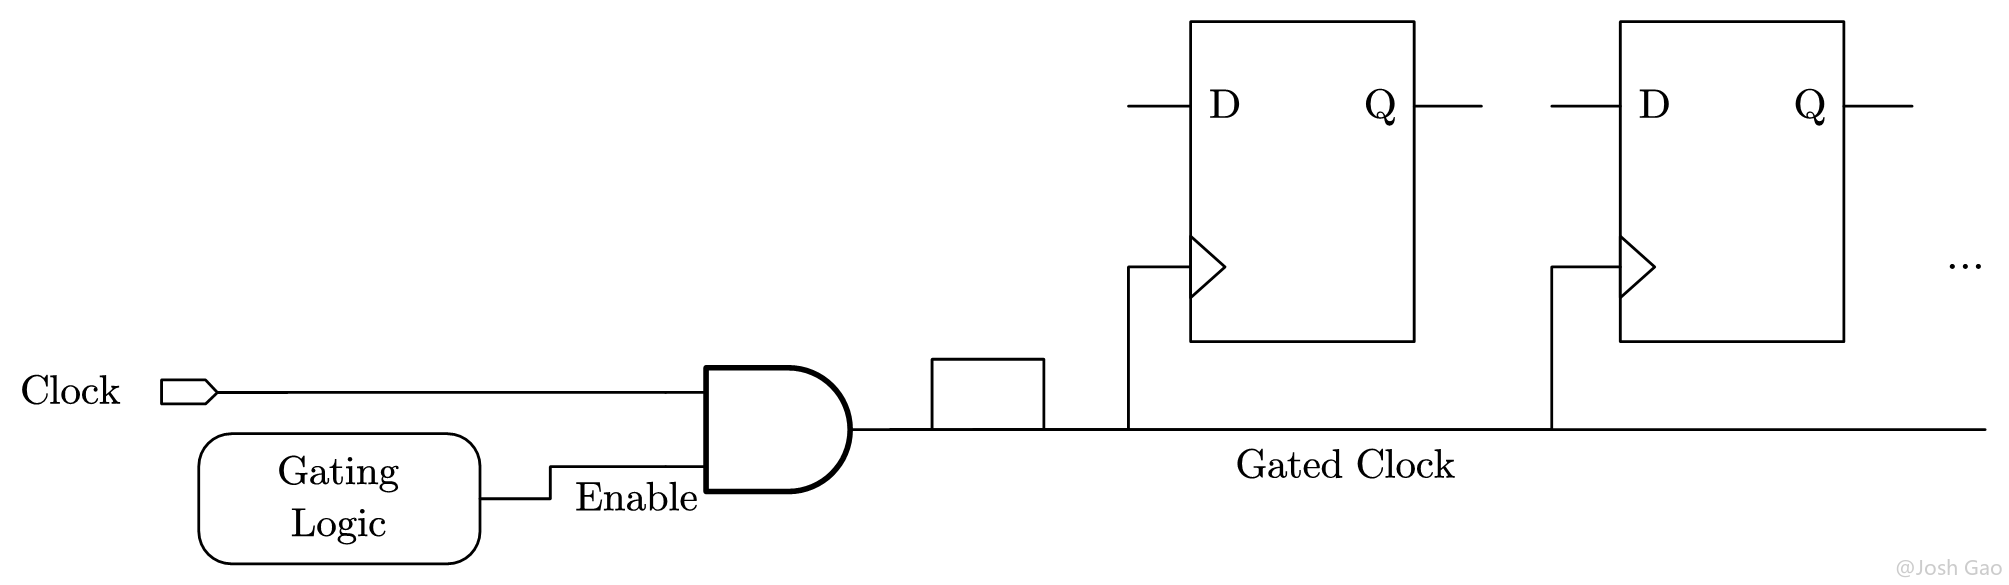{width=800px}
|
||||
{width=800px}
|
||||
|
||||
但是 Gated Clock 不是同步时序电路,其 Gating Logic(门控逻辑)会污染 Clock 的质量,通过控制门后会产生毛刺并使时钟的 Skew(偏斜)、Jitter(延时)等指标恶化。正如“[同步设计原则](#toc.2.1)” 一节所述,在同步时序电路中,应该尽量不使用 Gated Clock 。
|
||||
|
||||
@@ -864,7 +864,7 @@ endmodule
|
||||
|
||||
<a id="fig.5-18"></a>
|
||||
|
||||
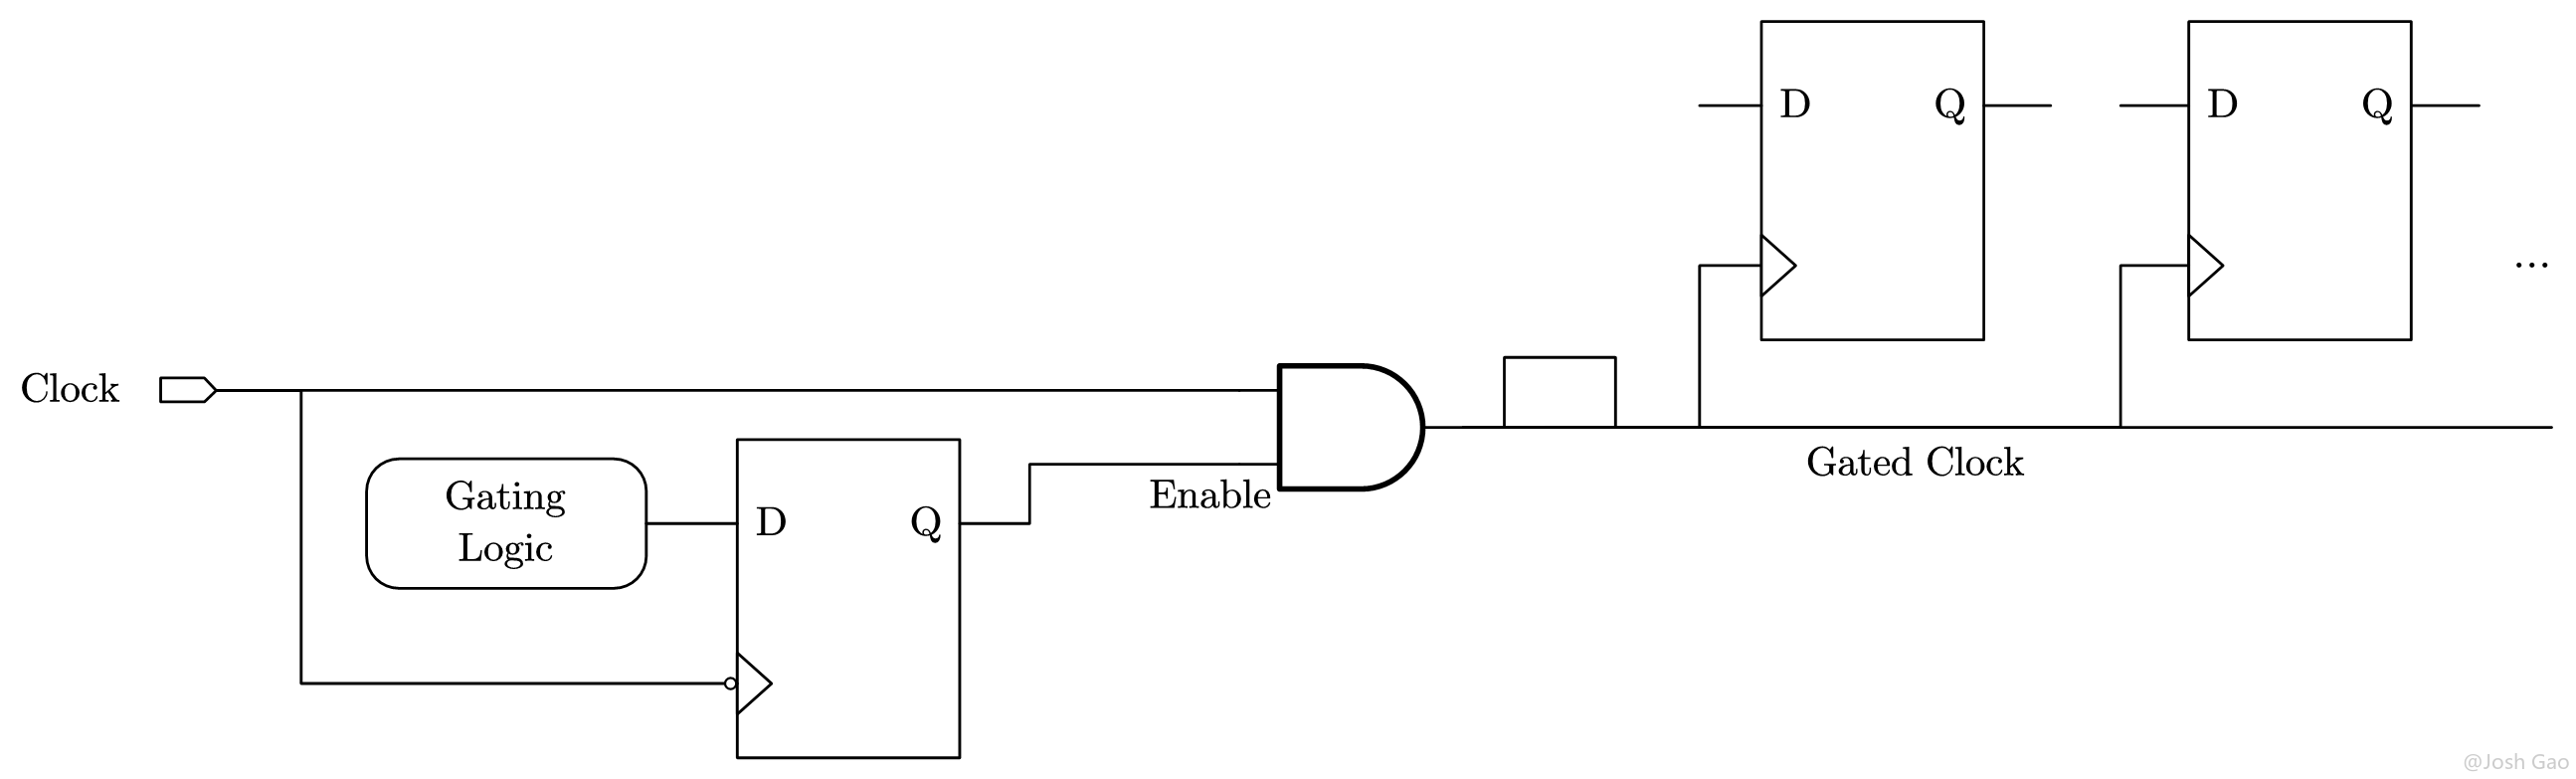{width=800px}
|
||||
{width=800px}
|
||||
|
||||
如果功耗真的成为了 PLD 设计的首要问题,建议采用其他方法减少功耗。如果最近发展起来的低核电压芯片(Core 电压为 1.0V),芯片休眠功能,Clock MUX 等新技术器件能有效地节约芯片功耗。
|
||||
|
||||
@@ -876,7 +876,7 @@ endmodule
|
||||
|
||||
<a id="fig.5-19"></a>
|
||||
|
||||
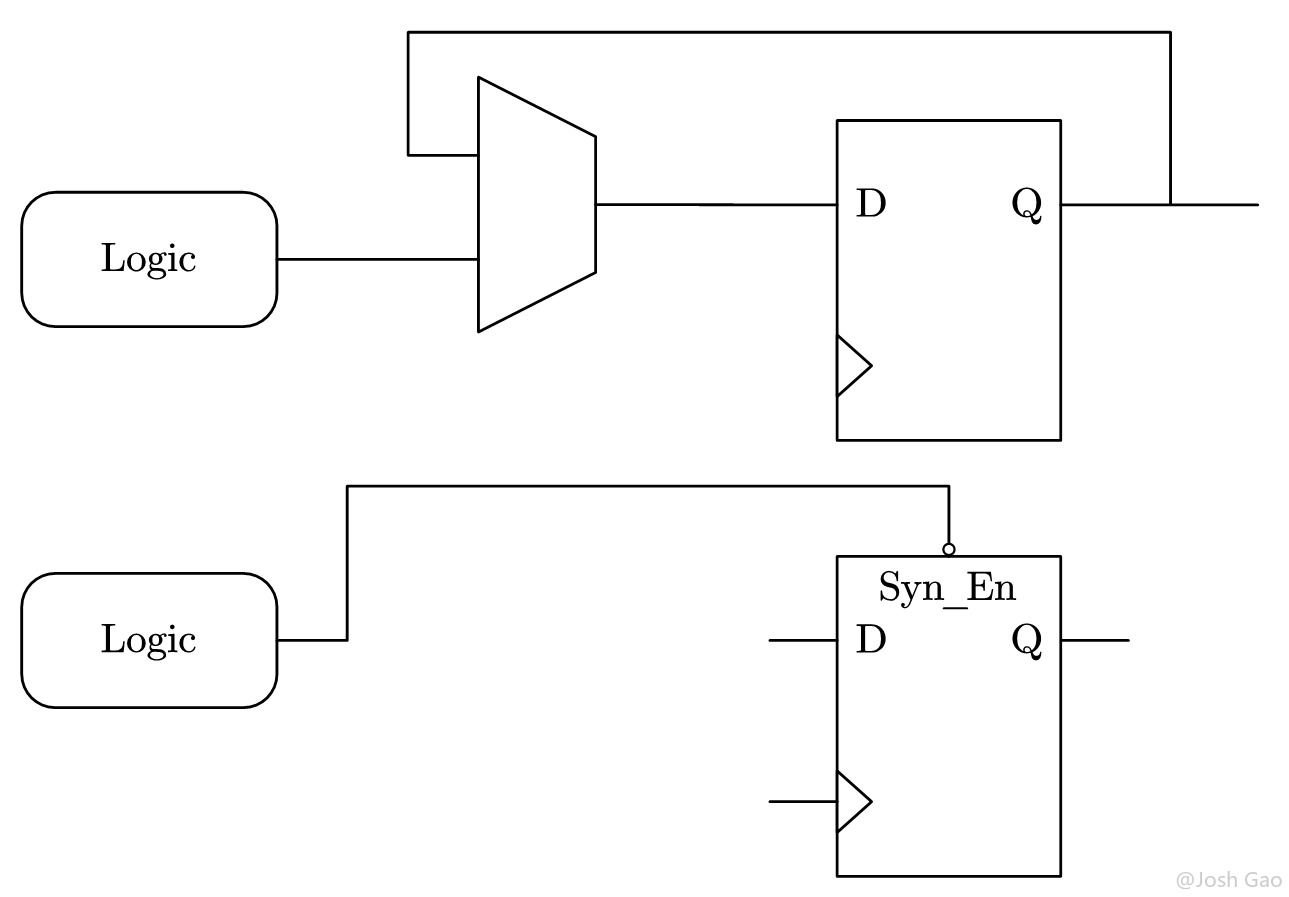{width=500px}
|
||||
{width=500px}
|
||||
|
||||
# 7. RTL 代码优化技巧<a id="toc.7"></a>
|
||||
|
||||
@@ -924,11 +924,11 @@ endmodule
|
||||
|
||||
<a id="fig.5-20"></a>
|
||||
|
||||
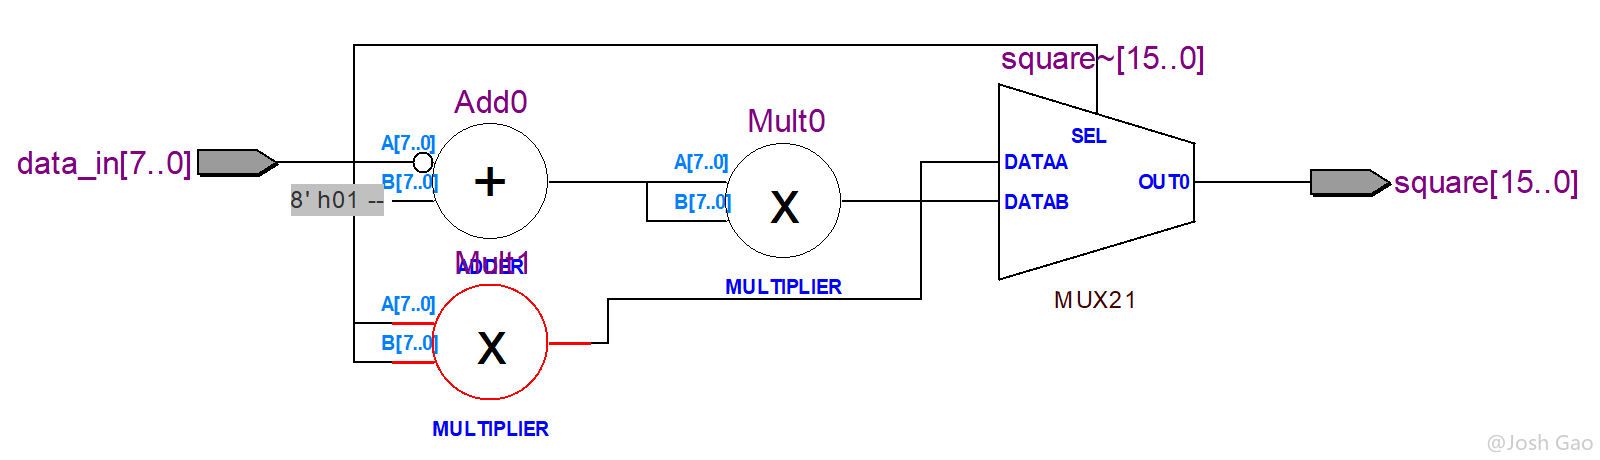{width=800px}
|
||||
{width=800px}
|
||||
|
||||
<a id="fig.5-21"></a>
|
||||
|
||||
{width=800px}
|
||||
{width=800px}
|
||||
|
||||
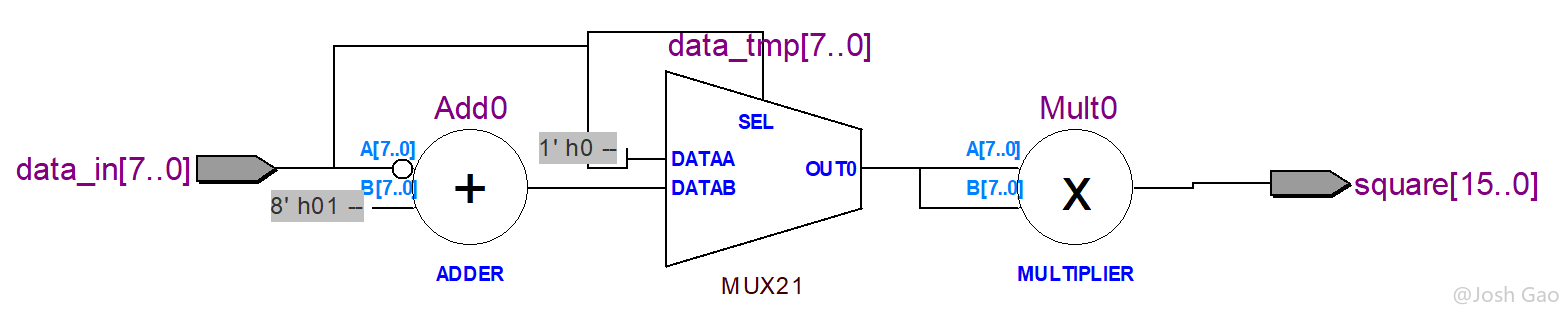
对于综合后的 RTL 视图,这里需要强调以下几点:
|
||||
|
||||
@@ -946,7 +946,7 @@ endmodule
|
||||
|
||||
<a id="fig.5-22"></a>
|
||||
|
||||
{width=800px}
|
||||
{width=800px}
|
||||
|
||||
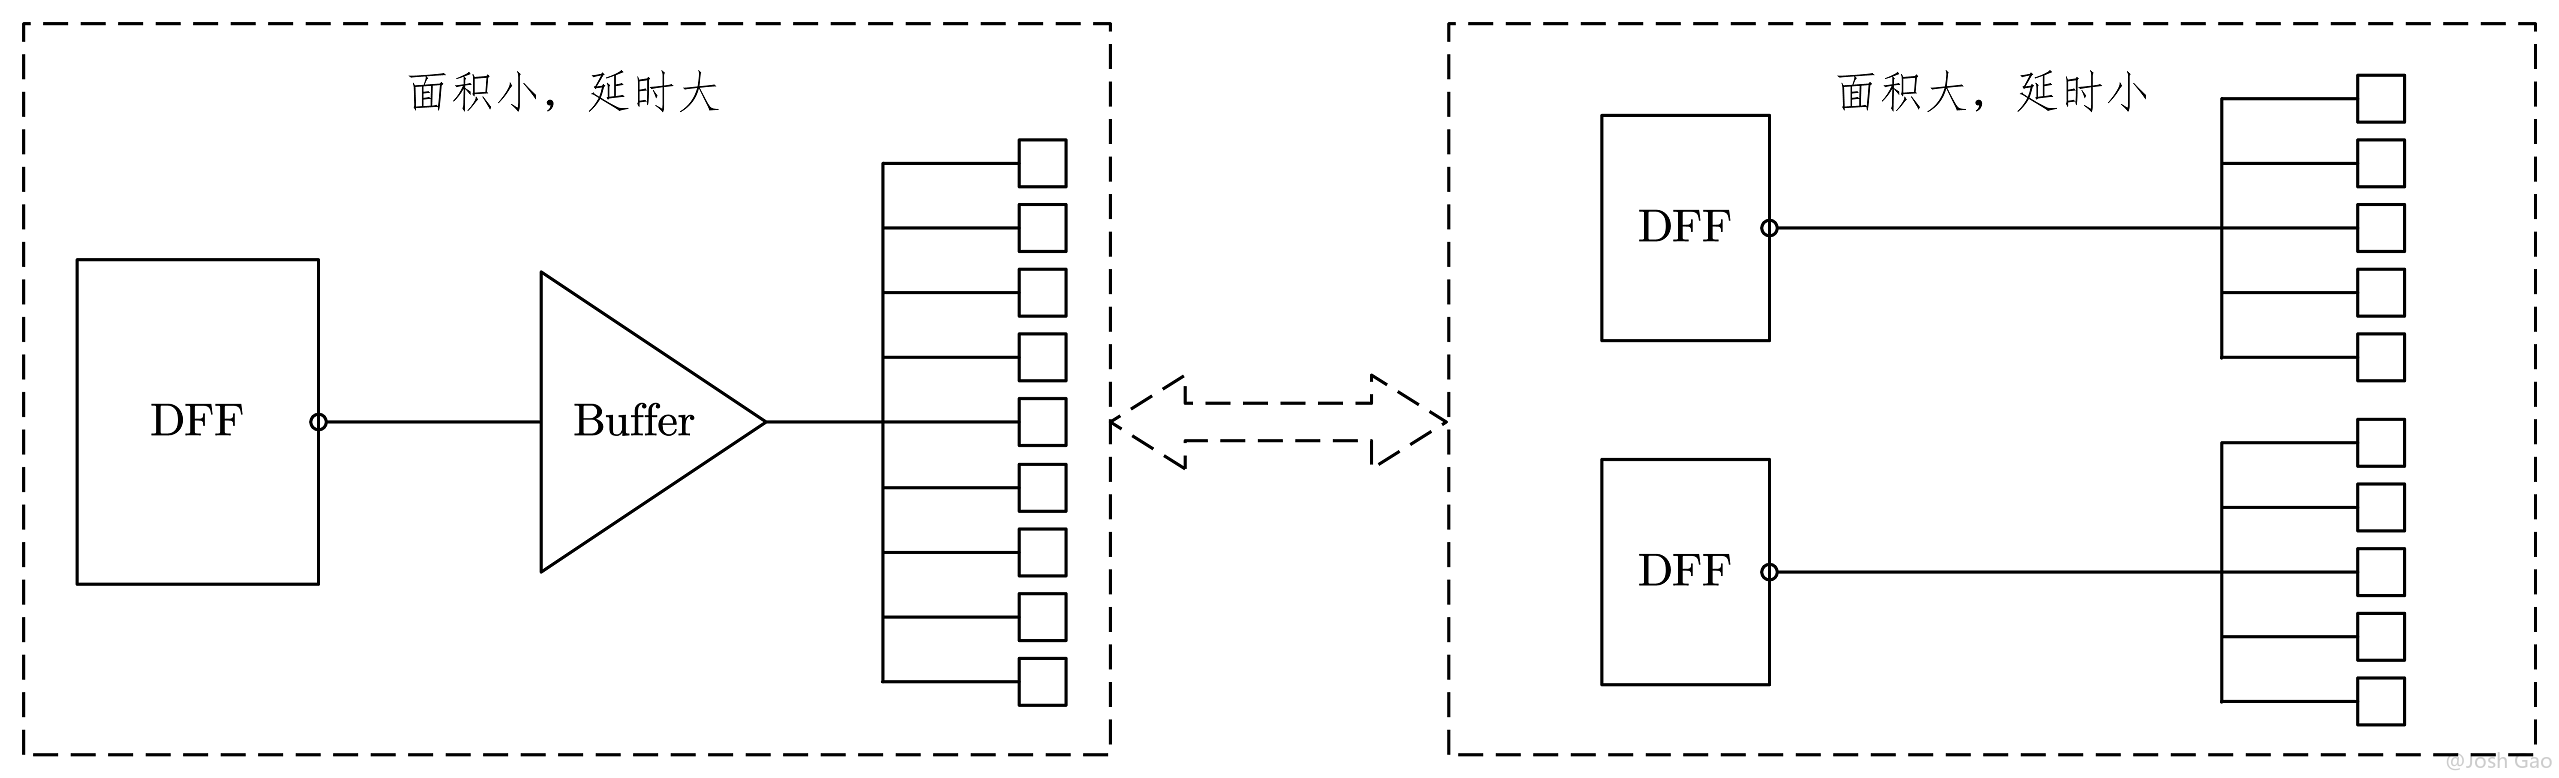
需要说明的是,现在很多综合工具都可以自动设置最大扇出值(Max Fanout),如果某个信号的扇出值大于最大扇出,则该信号自动被综合工具复制。最大扇出值和器件的工艺密切相关,其合理值应该根据器件手册的声明和工程经验设置。这里举例用逻辑复制手段调整扇出,达到优化路径时延仅仅是为了讲述逻辑复制的概念,其实逻辑复制还有其他很多形式。例如,香农扩展(Shannon Expansion)等时序优化技术,香农扩展在后面将会有详细的介绍。
|
||||
|
||||
@@ -960,7 +960,7 @@ endmodule
|
||||
|
||||
<a id="fig.5-23"></a>
|
||||
|
||||
{width=700px}
|
||||
{width=700px}
|
||||
|
||||
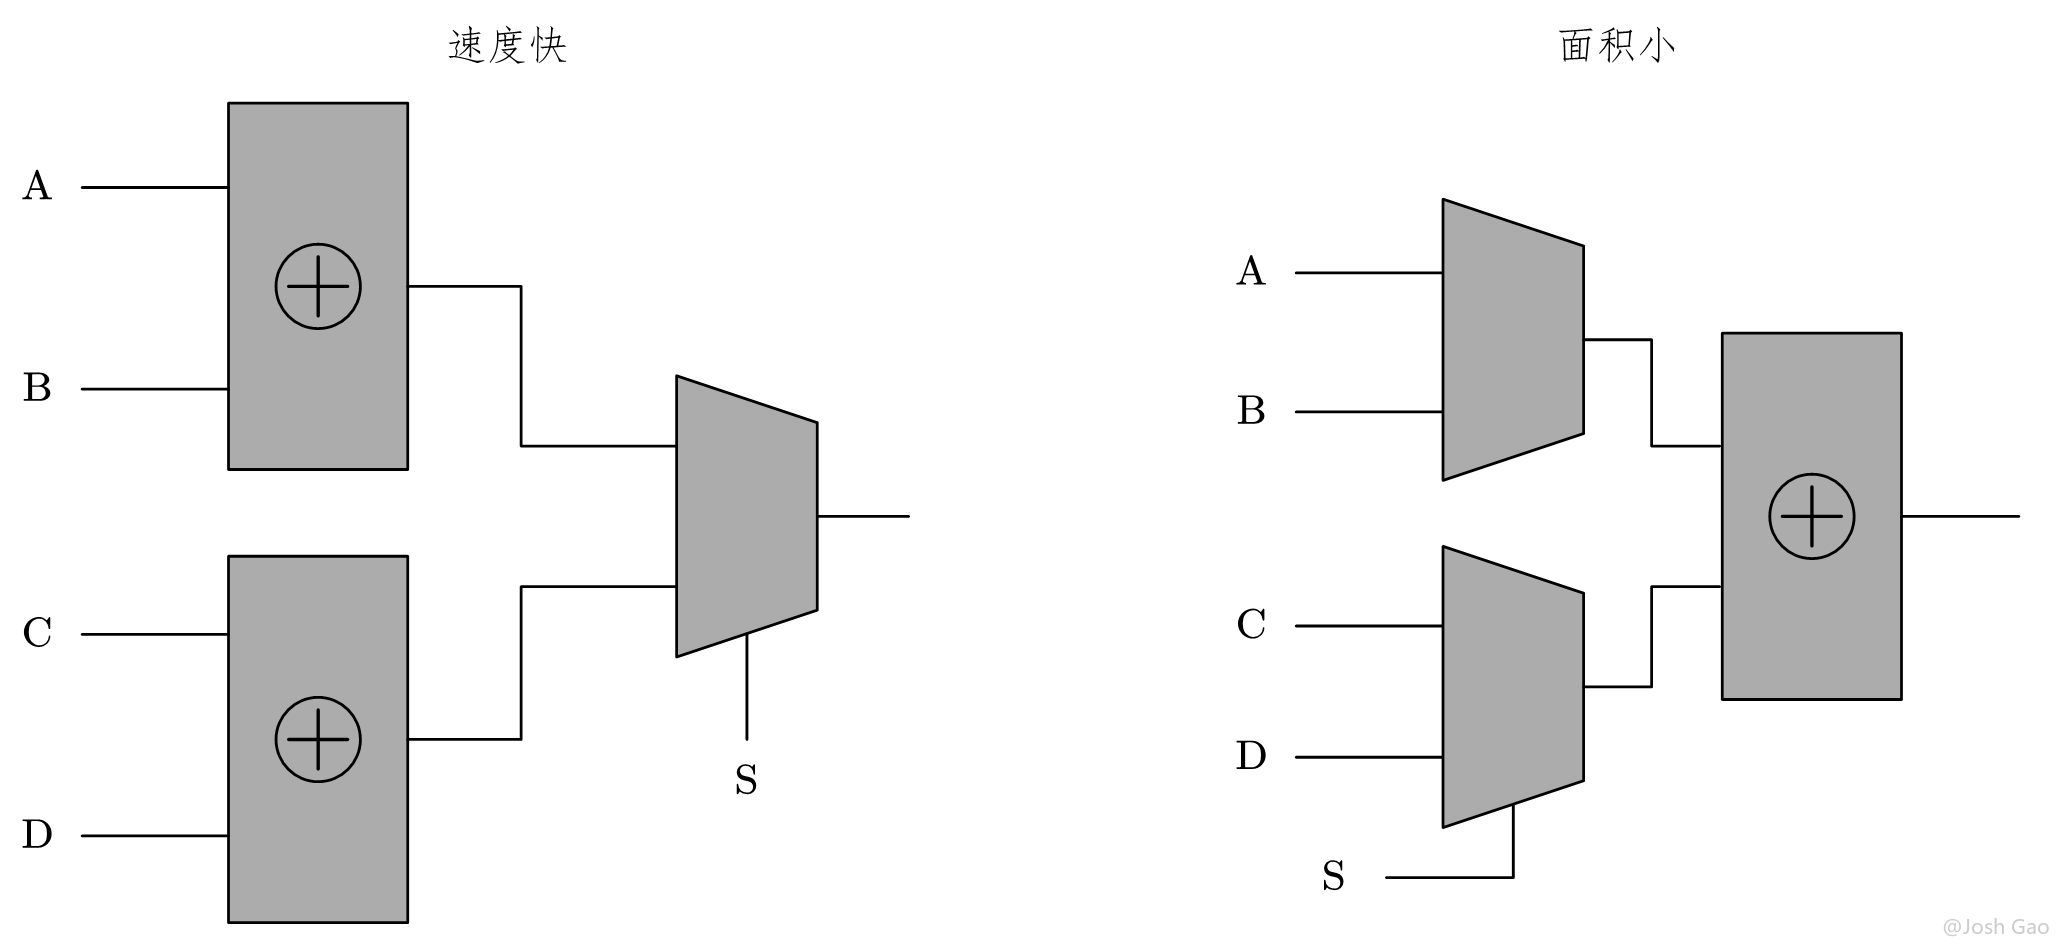
第一种写法,对应左边的 RTL 结构示意图:
|
||||
|
||||
@@ -1043,7 +1043,7 @@ endmodule
|
||||
|
||||
<a id="fig.5-24"></a>
|
||||
|
||||
{width=1000px}
|
||||
{width=1000px}
|
||||
|
||||
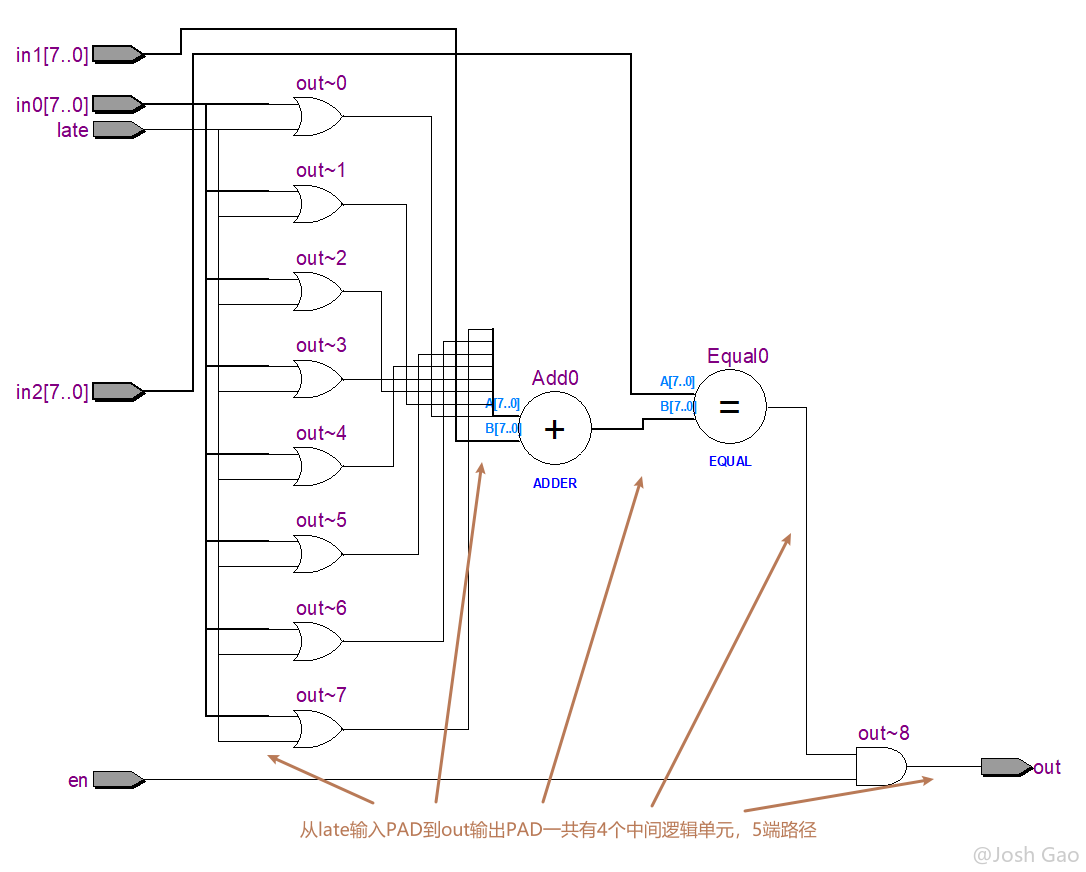
从图中可以清晰地看到,未使用香农扩展时,从输入 PAD late 到输出 PAD out 之间共有4 个逻辑单元, 5 段路径。其综合结果使用了 8 个 2 输入或门,1 个 8 bit 输入加法器, 1 个 8 bit 比较器, 1 个 2 输入与门。
|
||||
|
||||
@@ -1068,7 +1068,7 @@ endmodule
|
||||
|
||||
<a id="fig.5-25"></a>
|
||||
|
||||
{width=1000px}
|
||||
{width=1000px}
|
||||
|
||||
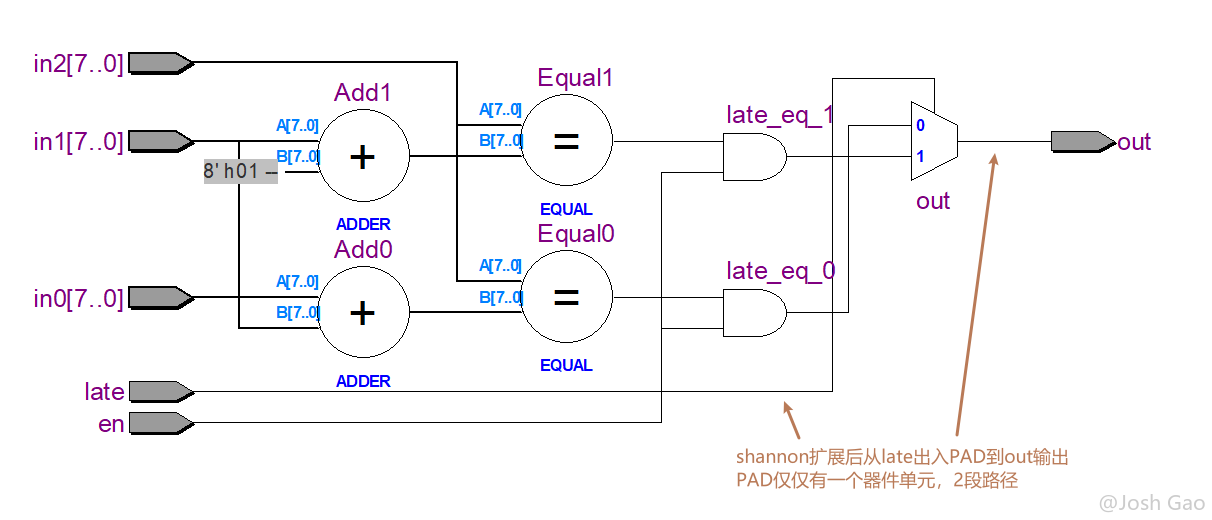
在图中可以清晰地看到,使用香农扩展后,从输入 PAD late 到输出 PAD out 之间共有 1 个逻辑单元,2 段路径。其综合结果使用了 2 个 8 bit 输入加法器, 2 个 8 bit 比较器,2 个输入与门和一个 2 输入选择器。
|
||||
|
||||
@@ -1091,7 +1091,7 @@ endmodule
|
||||
|
||||
<a id="fig.5-26"></a>
|
||||
|
||||
{width=1000px}
|
||||
{width=1000px}
|
||||
|
||||
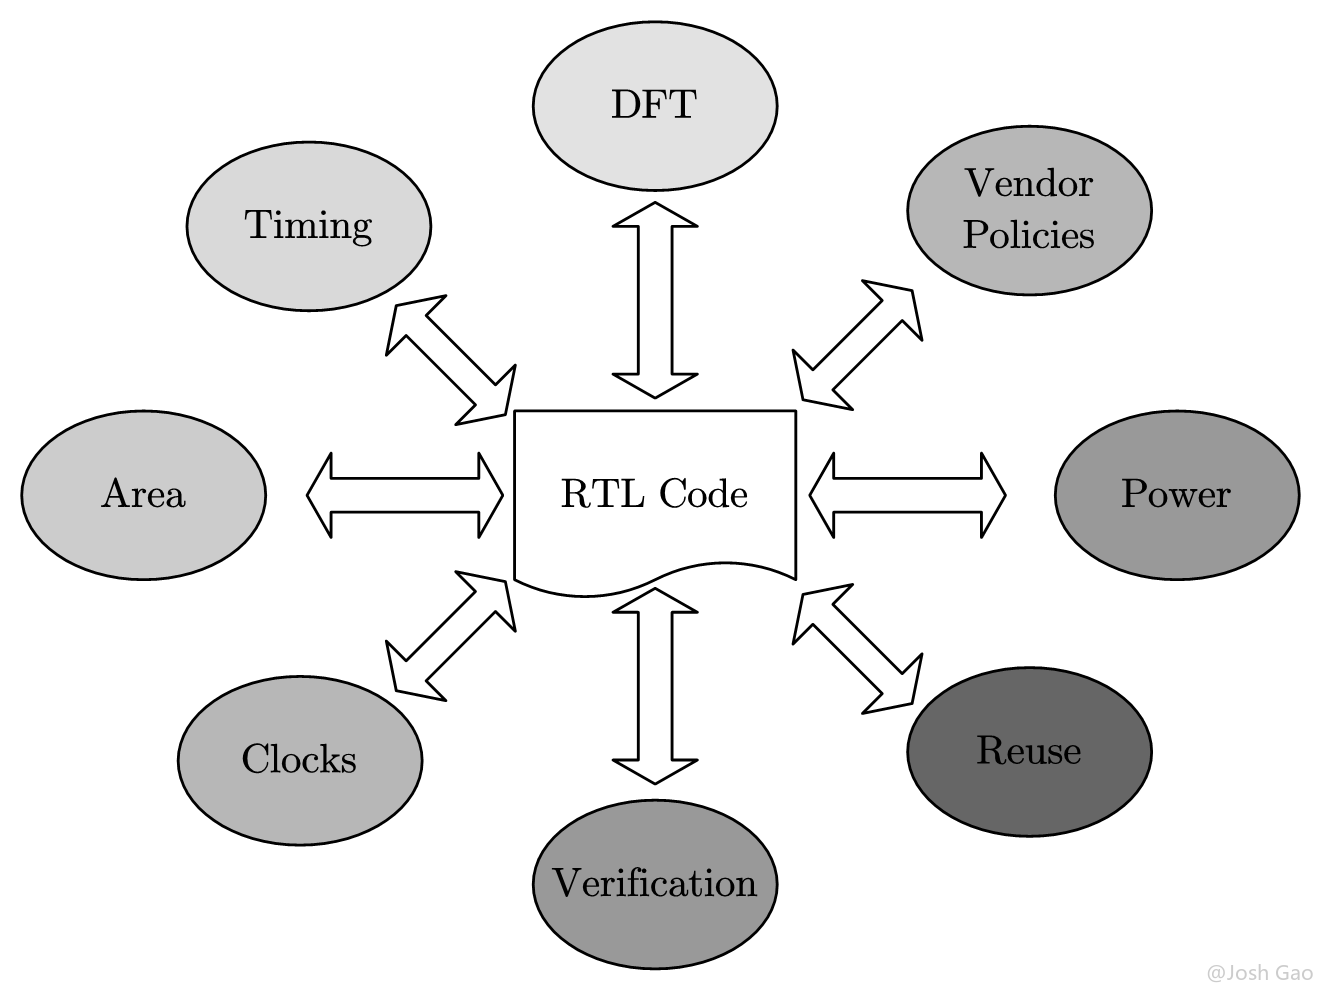
对一个 RTL 设计求全责备地要求它同时满足上述所有目标是非常困难的,应该根据这个RTL 设计的实现载体和具体应用,分析上述要求对本设计的重要性,然后综合考虑以上因素。
|
||||
|
||||
|
||||
Reference in New Issue
Block a user