@@ -74,9 +74,9 @@ RTL 级设计的评判标准有很多,如时序性能、所占面积、可测
### 1.1.1 “用速度的优势换面积的节约”举例
WCDMA(宽带码分多址)系统中使用到了快速哈达码(Fast Hadamard Transform, FHT)运算, FHT 由 4 步相同的算法完成,如[图 5-1 ](#图 5-1 ) 所示。
WCDMA(宽带码分多址)系统中使用到了快速哈达码(Fast Hadamard Transform, FHT)运算, FHT 由 4 步相同的算法完成,如[图 5-1 ](#fig. 5-1 ) 所示。
<a name="图 5-1"></a>
<a name="fig. 5-1"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-010-FastHadamardTransform.png!sign" alt="FHT 原理图"/>
</div>
@@ -246,9 +246,9 @@ end
endmodule
` ``
评估一下系统的流水线时间余量后,发现整个流水线有 16 个时钟周期,而 FHT 模块的频率很高,加法本身仅消耗 1 个时钟周期,加上数据的选择和分配所消耗时间,也完全能满足系统频率要求,所以**将单步 FHT 运算复用 4 次**,就能大幅度节约所消耗的资源。这种复用单步算法的FHT 实现框图如[图 5-2](#图 5-2) 所示,由输入选择寄存、单步FHT 模块、输出选择寄存和计数器构成。
评估一下系统的流水线时间余量后,发现整个流水线有 16 个时钟周期,而 FHT 模块的频率很高,加法本身仅消耗 1 个时钟周期,加上数据的选择和分配所消耗时间,也完全能满足系统频率要求,所以**将单步 FHT 运算复用 4 次**,就能大幅度节约所消耗的资源。这种复用单步算法的FHT 实现框图如[图 5-2](#fig. 5-2) 所示,由输入选择寄存、单步FHT 模块、输出选择寄存和计数器构成。
<a name="图 5-2"></a>
<a name="fig. 5-2"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-020-FHTOperationReuseStructureDiagram.png!sign" width="500px" alt="FHT 运算复用结构图"/>
</div>
@@ -362,14 +362,14 @@ end
endmodule
` ``
为了便于对比两种实现方式的资源消耗,在 Synplify Pro 中对两种实现方法分别做了综合。两次综合选用的参数都完全一致,所以仅考察设计所消耗的寄存器和逻辑资源,选 中Disable I/O In sertion 选项,不插入 I/O,取消 Synplify Pro 中诸如 FSM Compiler、FSM Explorer、Resource Sharing、Retiming、Pipelining等综合优化选项。两次综合的结果如[图 5-3](#图 5-3) 和[图 5-4](#图 5-4) 所示。
为了便于对比两种实现方式的资源消耗,在 Synplify Pro 中对两种实现方法分别做了综合。两次综合选用的参数都完全一致,所以仅考察设计所消耗的寄存器和逻辑资源,选 中Disable I/O In sertion 选项,不插入 I/O,取消 Synplify Pro 中诸如 FSM Compiler、FSM Explorer、Resource Sharing、Retiming、Pipelining等综合优化选项。两次综合的结果如[图 5-3](#fig. 5-3) 和[图 5-4](#fig. 5-4) 所示。
<a name="图 5-3"></a>
<a name="fig. 5-3"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-030-FHTPARTResource.bmp!sign" alt="未采用复用方案的“fhtpart”模块综合所消耗的资源"/>
</div>
<a name="图 5-4"></a>
<a name="fig. 5-4"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-040-WCHFHTResource.bmp!sign" alt="采用复用方案的“wch_fht”模块综合所消耗的资源"/>
</div>
@@ -380,9 +380,9 @@ endmodule
举一个通过复制模块,并行处理达到高处理带宽的例子(可实际应用于无线系统、有线接入、路由器、视频系统等)。假设输入数据流的速率是 800 Mbit/s,而 FPGA 上设计的数据处理模块的处理速度最大为 200 Mbit/s,由于处理模块的数据吞吐量满足不了要求,直接在 FPGA 上实现这个设计是一个“impossible mission”!
这种情况下。就应该利用“面积换速度”的思想,至少复制 4 个处理模块,**首先将输入数据进行串/并转换**,然后利用这 4 个模块并行处理分配的数据,**最后将处理结果并/串变换**,完成数据速率的要求。在整个处理模块的两端看,数据速率仍然是 800 Mbit/s,而在 FPGA 的内部看,每个子模块处理的数据速率仅为 200 Mbit/s,其实整个数据的吞吐扯的保障是依赖于 4 个子模块并行处理完成的,也就是说利用了占用更多的芯片面积,实现了高速处理,通过使用“面积的复制换取处理速度的提高”的思想实现了设计。设计的示意框图如[图 5-5](#图 5-5) 所示。
这种情况下。就应该利用“面积换速度”的思想,至少复制 4 个处理模块,**首先将输入数据进行串/并转换**,然后利用这 4 个模块并行处理分配的数据,**最后将处理结果并/串变换**,完成数据速率的要求。在整个处理模块的两端看,数据速率仍然是 800 Mbit/s,而在 FPGA 的内部看,每个子模块处理的数据速率仅为 200 Mbit/s,其实整个数据的吞吐扯的保障是依赖于 4 个子模块并行处理完成的,也就是说利用了占用更多的芯片面积,实现了高速处理,通过使用“面积的复制换取处理速度的提高”的思想实现了设计。设计的示意框图如[图 5-5](#fig. 5-5) 所示。
<a name="图 5-5"></a>
<a name="fig. 5-5"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-050-MoreAreaforSpeed.png!sign" width="700px" alt="“面积换速度”示意图"/>
</div>
@@ -488,9 +488,9 @@ case (var)
从更高层面上看,对于任何一个硬件系统,如何进行模块划分与任务分配,什么样的算法和功能适合放在可编程逻辑器件或 ASIC 里面实现,什么样的算法和功能适合放在 DSP、CPU 等微处理器实现,如何划分软硬件功能,安排模块接口设计等问题都非常重要。要知道**在系统上复用模块节省的面积远比在代码上小打小闹来得实惠多。**
[图 5-6](#图 5-6) 描述了FPGA 设计的系统规划流程。我们可以发现**对设计从整体上进行模块复用应该在系统功能定义后就充分考虑**,并指导模块的具体划分。模块划分非常重要,除了关系到是否最大程度上发挥项目成员的协同设计能力,而且直接决定着设计的综合、实现效果和相关的操作时间,模块划分的具体方法请参考 4.2 小节中关于模块划分技巧的论述。
[图 5-6](#fig. 5-6) 描述了FPGA 设计的系统规划流程。我们可以发现**对设计从整体上进行模块复用应该在系统功能定义后就充分考虑**,并指导模块的具体划分。模块划分非常重要,除了关系到是否最大程度上发挥项目成员的协同设计能力,而且直接决定着设计的综合、实现效果和相关的操作时间,模块划分的具体方法请参考 4.2 小节中关于模块划分技巧的论述。
<a name="图 5-6"></a>
<a name="fig. 5-6"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-060-SystemPlanningProc.png!sign" width="700px" alt="系统规划的简化流程"/>
</div>
@@ -499,9 +499,9 @@ case (var)
下举例说明如何在系统层次复用模块
利用“可编程匹配滤波器“实现 WCDMA 基站的方案,其核心是在合理规划系统的基础上,合理划分模块并安排操作时序,提高单元模块的复用率令从而大大降低硬件消耗,其设计思想是系统原则的集中体现。可编程匹配滤波器原理框图如[图 5-7](#图 5-7) 所示。
利用“可编程匹配滤波器“实现 WCDMA 基站的方案,其核心是在合理规划系统的基础上,合理划分模块并安排操作时序,提高单元模块的复用率令从而大大降低硬件消耗,其设计思想是系统原则的集中体现。可编程匹配滤波器原理框图如[图 5-7](#fig. 5-7) 所示。
<a name="图 5-7"></a>
<a name="fig. 5-7"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-070-ProgrammableMatchFilter.png!sign" width="500px" alt="系统规划的简化流程"/>
</div>
@@ -555,9 +555,9 @@ case (var)
在后续笔记中会介绍异步时钟域转换的问题,在谈这个话题之前,先分析一下什么是亚稳态,以及如何避免。
异步时钟域的转换的核心就是要保证下级时钟对上级数据采样的 Setup 时间和 Hold 时间。如果触发器的Setup 时间或者 Hold 时间不满足,就可能产生亚稳态,**此时触发器输出端 Q 在有效时钟沿之后比较长的一段时间内处于不确定的状态,在这段时间内 Q 端产生毛刺并不断振荡,最终固定在某一电压值,此电压值并不一定等于原来数据输入端 D 的数值**,这段时间称为决断时间(Resolution time)。经过 Resolution time 之后 Q 端将稳定到 0 或1, 但是究竟是 0 还是1,这是随机的,与输入没有必然的关系,其产生示意图如[图 5-8](#图 5-8) 所示。
异步时钟域的转换的核心就是要保证下级时钟对上级数据采样的 Setup 时间和 Hold 时间。如果触发器的Setup 时间或者 Hold 时间不满足,就可能产生亚稳态,**此时触发器输出端 Q 在有效时钟沿之后比较长的一段时间内处于不确定的状态,在这段时间内 Q 端产生毛刺并不断振荡,最终固定在某一电压值,此电压值并不一定等于原来数据输入端 D 的数值**,这段时间称为决断时间(Resolution time)。经过 Resolution time 之后 Q 端将稳定到 0 或1, 但是究竟是 0 还是1,这是随机的,与输入没有必然的关系,其产生示意图如[图 5-8](#fig. 5-8) 所示。
<a name="图 5-8"></a>
<a name="fig. 5-8"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-080-MetastableGenerate.png!sign" width="700px" alt="亚稳态产生示意图"/>
</div>
@@ -566,14 +566,14 @@ case (var)
**只要系统中有异步元件,亚稳态就无法避免**,因此设计的电路**首先要减少亚稳态导致的错误**,**其次要使系统对产生的错误不敏感**。前者要靠同步设计来实现,而后者则根据不同的设计应用不同的处理办法。
**使用两级以上寄存器采样可以有效地减少亚稳态继续传播的概率**。在[图 5-9](#图 5-9) 中,左边为异步输入端,经过两级触发器采样,在右边的输出与 ` bclk` 同步,而且该输出基本不存在亚稳态。其原理是使第一个触发器的输出端存在亚稳态,经过一个 clk 周期后,第二个触发器 D 端的电平仍未稳定的概率非常小,因此第二个触发器 Q 端基本不会产生亚稳态。理论上如果再添加一级寄存器,使同步采样达到 3 级,则末级输出为亚稳态的概率几乎为 0。
**使用两级以上寄存器采样可以有效地减少亚稳态继续传播的概率**。在[图 5-9](#fig. 5-9) 中,左边为异步输入端,经过两级触发器采样,在右边的输出与 ` bclk` 同步,而且该输出基本不存在亚稳态。其原理是使第一个触发器的输出端存在亚稳态,经过一个 clk 周期后,第二个触发器 D 端的电平仍未稳定的概率非常小,因此第二个触发器 Q 端基本不会产生亚稳态。理论上如果再添加一级寄存器,使同步采样达到 3 级,则末级输出为亚稳态的概率几乎为 0。
<a name="图 5-9"></a>
<a name="fig. 5-9"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-090-TwoStageRegisterSampling.png!sign" width="700px" alt="两级寄存器采样降低亚稳态概率"/>
</div>
使用[图 5-9](#图 5-9) 两级寄存器采样仅能降低亚稳态的概率,但是并不能保证第二级输出的稳态电平就是正确电平。前面说过经过 Resolution time 之后寄存器输出的电平是一个不确定的稳态值,也就是说**这种处理方法并不能排除采样错误的产生**,这时就**要求所设计的系统对采样错误有一定的容忍度**。有些应用本身就对采样错误不敏感,如一帧图像编码,一段话音编码等。而有些系统对错误采样比较敏感。这类由于亚稳态造成的采样是一些突发的错误,所以可以采用一些纠错编码手段完成错误的纠正。
使用[图 5-9](#fig. 5-9) 两级寄存器采样仅能降低亚稳态的概率,但是并不能保证第二级输出的稳态电平就是正确电平。前面说过经过 Resolution time 之后寄存器输出的电平是一个不确定的稳态值,也就是说**这种处理方法并不能排除采样错误的产生**,这时就**要求所设计的系统对采样错误有一定的容忍度**。有些应用本身就对采样错误不敏感,如一帧图像编码,一段话音编码等。而有些系统对错误采样比较敏感。这类由于亚稳态造成的采样是一些突发的错误,所以可以采用一些纠错编码手段完成错误的纠正。
## 2.3 异步时钟域数据同步<a name="0203"></a>
@@ -617,18 +617,18 @@ case (var)
1. 同频异相问题
同频异相问题的简单解决方法是**用后级时钟对前级数据采样两次**,即通常所述的**用寄存器打两次**。数据同步如[图 5-10](#图 5-10) 所示,这样的做法是有效地减少了亚稳态的传播,使后级电路数据都是有效电平值。但是这种做法并不能保证两级寄存器采样后的数据是正确的电平值,因为一旦 Setup 或 Hold 时间不满足,采样发生亚稳态,则经判决时间(Resolution Time)后,还是可能判决到错误电平值。所以这种方法仅仅适用于对少量错误不敏感的功能单元。
同频异相问题的简单解决方法是**用后级时钟对前级数据采样两次**,即通常所述的**用寄存器打两次**。数据同步如[图 5-10](#fig. 5-10) 所示,这样的做法是有效地减少了亚稳态的传播,使后级电路数据都是有效电平值。但是这种做法并不能保证两级寄存器采样后的数据是正确的电平值,因为一旦 Setup 或 Hold 时间不满足,采样发生亚稳态,则经判决时间(Resolution Time)后,还是可能判决到错误电平值。所以这种方法仅仅适用于对少量错误不敏感的功能单元。
<a name="图 5-10"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-100-DataSynchronization.png!sign" width="700px" alt="数据同步"/>
</div>
<a name="fig. 5-10"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-100-DataSynchronization.png!sign" width="700px" alt="数据同步"/>
</div>
可靠的做法是用 DPRAM 、FIFO 或者一段寄存器 Buffer 完成异步时钟域的数据转换。把数据存放在 DPRAM 或FIFO 的方法如下:将上级芯片提供的数据随路时钟作为写信号,将数据写入 DPRAM 或者FIFO, 然后使用本级的采样时钟( 一般是数据处理的主时钟),将数据读出即可。由于时钟频率相同,所以 DPRAM 或 FIFO 两端的数据吞吐率一致,实现起来相对简单。
可靠的做法是用 DPRAM 、FIFO 或者一段寄存器 Buffer 完成异步时钟域的数据转换。把数据存放在 DPRAM 或FIFO 的方法如下:将上级芯片提供的数据随路时钟作为写信号,将数据写入 DPRAM 或者FIFO, 然后使用本级的采样时钟( 一般是数据处理的主时钟),将数据读出即可。由于时钟频率相同,所以 DPRAM 或 FIFO 两端的数据吞吐率一致,实现起来相对简单。
2. 异频问题
可靠完成异频问题的解决方法就是使用 DPRAM 或 FIFO 。其实现思路与前面所述一致,用上级随路时钟写上级数据,然后用本级时钟读出数据。但是由于时钟频率不同,所以两个端口的数据吞吐率不一致,设计时一定要开好缓冲区,并通过监控(Full、Half、Empty 等指示)确保数据流不会溢出。
可靠完成异频问题的解决方法就是使用 DPRAM 或 FIFO 。其实现思路与前面所述一致,用上级随路时钟写上级数据,然后用本级时钟读出数据。但是由于时钟频率不同,所以两个端口的数据吞吐率不一致,设计时一定要开好缓冲区,并通过监控(Full、Half、Empty 等指示)确保数据流不会溢出。
# 3. 代码风格
@@ -654,12 +654,11 @@ case (var)
## 4.1 结构层次化编码
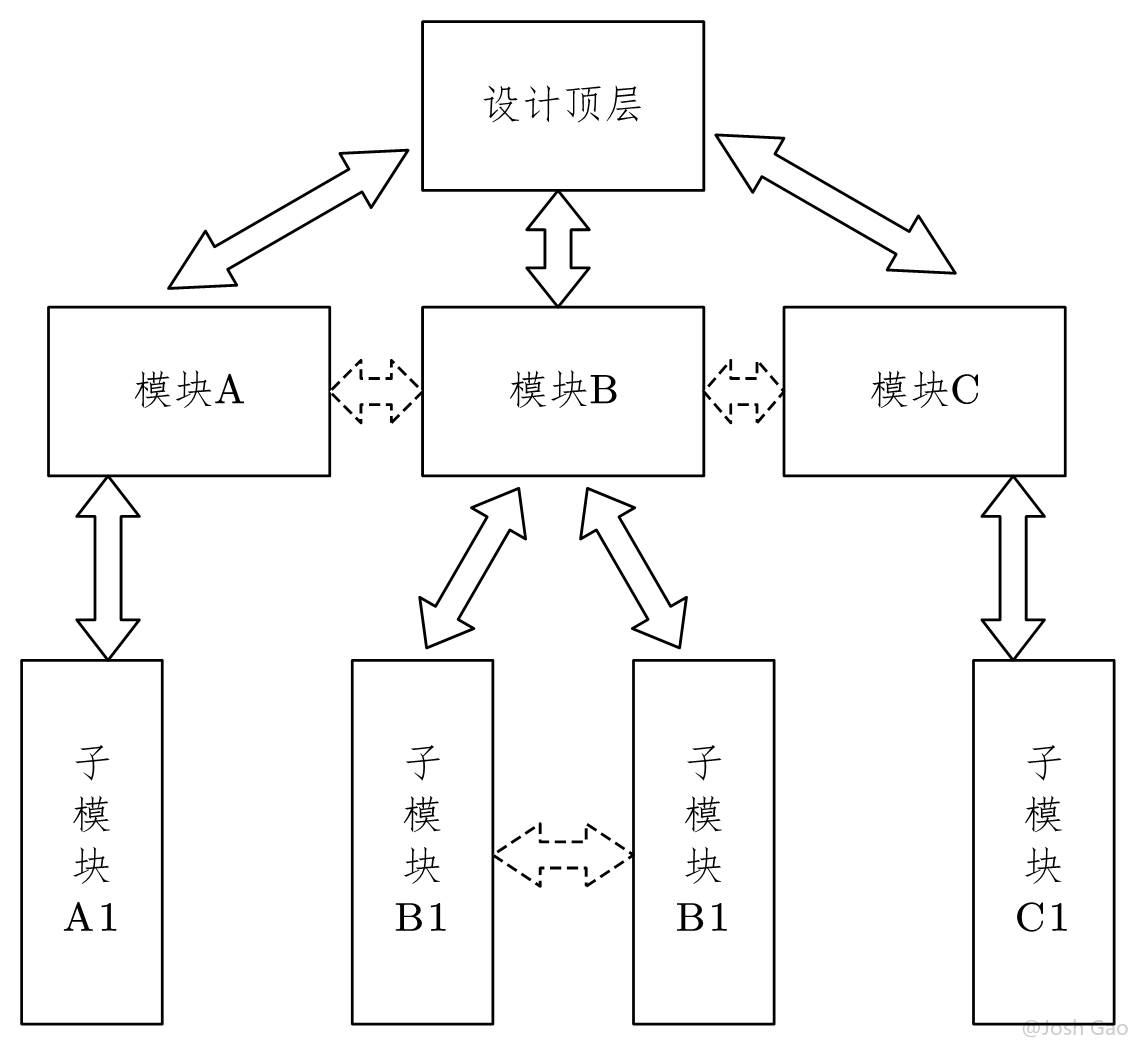
结构层次化编码(Hierarchical Coding)是模块化设计思想的一种体现。目前大型设计中必须采用结构层次化编码风格,以提高代码的可读性,易于模块划分,易于分工协作,易于设计仿真测试激励。最基本的结构化层次是由一个顶层模块和若干个子模块构成,每个子模块根据需要还可以包含自己的子模块。结构层次化编码结构如[图 5-11](#图 5-11) 所示。
结构层次化编码(Hierarchical Coding)是模块化设计思想的一种体现。目前大型设计中必须采用结构层次化编码风格,以提高代码的可读性,易于模块划分,易于分工协作,易于设计仿真测试激励。最基本的结构化层次是由一个顶层模块和若干个子模块构成,每个子模块根据需要还可以包含自己的子模块。结构层次化编码结构如[图 5-11](#fig. 5-11) 所示。
<a name="图 5-11"></a>
<div align="center">
<img src=" https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-110-StructuredCoding.png!sign" width="5 00px" alt="结构层次化编码示意图"/>
</div>
<a name="fig. 5-11"></a>
{ width=6 00px}
结构层次化编码有如下注意事项:
@@ -683,27 +682,27 @@ case (var)
1. **对每个同步时序设计的子模块的输出使用寄存器**
这也被称为用寄存器分割同步时序模块的原则。使用寄存器分割同步时序单元的好处是:便于综合工具权衡所分割的子模块中的组合电路部分和同步时序电路部分,从而达到更好的时序优化效果,这种模块划分符合时序约束的习惯,便于利用约束属性进行时序约束。
这也被称为用寄存器分割同步时序模块的原则。使用寄存器分割同步时序单元的好处是:便于综合工具权衡所分割的子模块中的组合电路部分和同步时序电路部分,从而达到更好的时序优化效果,这种模块划分符合时序约束的习惯,便于利用约束属性进行时序约束。
2. **将相关的逻辑或者可以复用的逻辑划分在同一模块内**
这个做法有时被称为**呼应系统原则**。这样做的好处有:一方面将相关的逻辑和可以复用的逻辑划分在同一模块,可在最大程度上复用资源,减少设计所消耗的面积;另一方面更利于综合工具优化某个具体功能的时序关键路径。其原因是,传统的综合工具只能同时优化某一部分的逻辑,而所能同时优化的逻辑的从本单元就是模块,所以将相关功能划分在同一模块将在时序和面积上获得更好的综合优化效果。
这个做法有时被称为**呼应系统原则**。这样做的好处有:一方面将相关的逻辑和可以复用的逻辑划分在同一模块,可在最大程度上复用资源,减少设计所消耗的面积;另一方面更利于综合工具优化某个具体功能的时序关键路径。其原因是,传统的综合工具只能同时优化某一部分的逻辑,而所能同时优化的逻辑的从本单元就是模块,所以将相关功能划分在同一模块将在时序和面积上获得更好的综合优化效果。
3. **将不同优化目标的逻辑分开**
在介绍速度、面积平衡与互换原则时,合理的设计目标应该综合考虑面积最小和频率最高两个指标。好的设计,在规划阶段设计者就应该初步规划了设计的规模和时序关键路径,并对设计的优化目标有一个整体上的把握。对于时序紧张的部分.应该独立划分为一个模块.其优化目标为“Speed”,这种划分方法便于设计者进行时序约束,也便于综合和实现工具进行优化。目前很多综合与实现工具都支持物理区域位置约束,以模块为单元进行物理区域约束,从而优化关键路径时序,以达到更高的系统工作频率就更为方便有效。另一类情况是,设计的矛盾主要集中在芯片的资源消耗上。这时应该将资源消耗过大的部分划分为独立的模块,这类模块的优化目标应该定为“Area” 。同理,将它们规划到一起,更有利于区域布局与约束。这种根据优化目标进行优化的方法最大好处是,对于某个模块综合器仅需要考虑一种优化目标和策略,从而比较容易达到较好的优化效果。相反,如果同时考虑两种优化目标,会使综合器陷入互相制约的困境,耗费巨大的综合优化时间也得不到令人满意的综合优化结果。
在介绍速度、面积平衡与互换原则时,合理的设计目标应该综合考虑面积最小和频率最高两个指标。好的设计,在规划阶段设计者就应该初步规划了设计的规模和时序关键路径,并对设计的优化目标有一个整体上的把握。对于时序紧张的部分.应该独立划分为一个模块.其优化目标为“Speed”,这种划分方法便于设计者进行时序约束,也便于综合和实现工具进行优化。目前很多综合与实现工具都支持物理区域位置约束,以模块为单元进行物理区域约束,从而优化关键路径时序,以达到更高的系统工作频率就更为方便有效。另一类情况是,设计的矛盾主要集中在芯片的资源消耗上。这时应该将资源消耗过大的部分划分为独立的模块,这类模块的优化目标应该定为“Area” 。同理,将它们规划到一起,更有利于区域布局与约束。这种根据优化目标进行优化的方法最大好处是,对于某个模块综合器仅需要考虑一种优化目标和策略,从而比较容易达到较好的优化效果。相反,如果同时考虑两种优化目标,会使综合器陷入互相制约的困境,耗费巨大的综合优化时间也得不到令人满意的综合优化结果。
4. **将时序约束较松的逻辑归到同一模块**
有些逻辑的时序非常宽松,不需要较高的时序约束,可以将这类逻辑归入同一模块,如多周期路径(Multi-cycle Path)等。将这些模块归类,并指定宽松约束,则可以让综合器尽量节省面积资源。
有些逻辑的时序非常宽松,不需要较高的时序约束,可以将这类逻辑归入同一模块,如多周期路径(Multi-cycle Path)等。将这些模块归类,并指定宽松约束,则可以让综合器尽量节省面积资源。
5. **将存储逻辑独立划分成模块**
RAM、ROM、CAM 和 FIFO 等存储单元应该独立划分模块。这样做的好处是便于利用综合约束属性显化指定这些存储单元的结构和所使用的资源类型,也便于综合器将这些存储单元自动类推为指定器件的硬件原语。另一个好处是在仿真时消耗的内存也会减少,便于提高仿真速度。这是因为大多数仿真器对大面积的RAM都有独特的内存管理方式,以提高仿真效率。
RAM、ROM、CAM 和 FIFO 等存储单元应该独立划分模块。这样做的好处是便于利用综合约束属性显化指定这些存储单元的结构和所使用的资源类型,也便于综合器将这些存储单元自动类推为指定器件的硬件原语。另一个好处是在仿真时消耗的内存也会减少,便于提高仿真速度。这是因为大多数仿真器对大面积的RAM都有独特的内存管理方式,以提高仿真效率。
6. **合适的模块规模**
从理论上讲,模块的规模越大,越利于模块资源共享(Resource Sharing)。但是庞大的模块,将要求对综合器同时处理更多的逻辑结构.这将对综合器的处理能力和计算机的配置提出了较高的要求。另外,庞大的模块划分,不利于发挥目前非常流行的增拭综合与实现技术的优势。
从理论上讲,模块的规模越大,越利于模块资源共享(Resource Sharing)。但是庞大的模块,将要求对综合器同时处理更多的逻辑结构.这将对综合器的处理能力和计算机的配置提出了较高的要求。另外,庞大的模块划分,不利于发挥目前非常流行的增拭综合与实现技术的优势。
# 5. 组合逻辑的注意事项<a name="05"></a>
@@ -727,12 +726,11 @@ case (var)
**组合逻辑反馈环路是数字同步逻辑设计的大忌**,它最容易因振荡、毛刺、时序违规等引起整个系统的不稳定和不可靠。
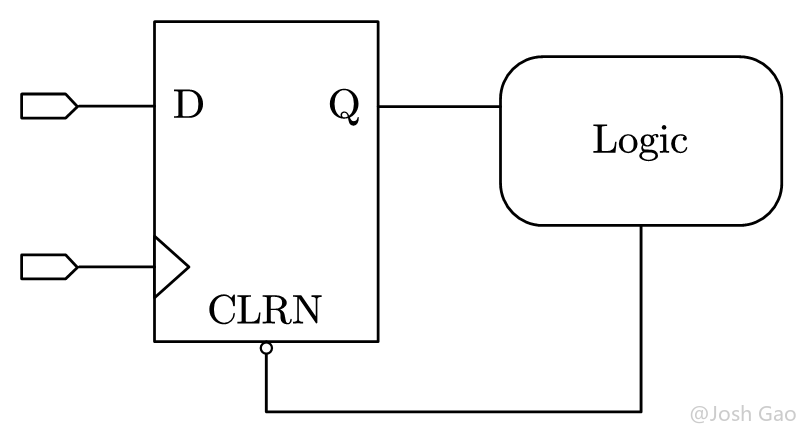
典型的组合逻辑反馈环路如[图 5-12](#图 5-12) 所示,寄存器的 Q 端输出直接通过组合逻辑反馈到寄存器的异步复位端,如果 Q 输出为 0 时,经组合逻辑运算后为异步复位端有效,则电路进入不断清零的死循环。
典型的组合逻辑反馈环路如[图 5-12](#fig. 5-12) 所示,寄存器的 Q 端输出直接通过组合逻辑反馈到寄存器的异步复位端,如果 Q 输出为 0 时,经组合逻辑运算后为异步复位端有效,则电路进入不断清零的死循环。
<a name="图 5-12"></a>
<div align="center">
<img src=" https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-120-CombinatorialLogicFeedbackLoop.png!sign" width="400px" alt="组合逻辑反馈环路示意图"/>
</div>
<a name="fig. 5-12"></a>
{ width="400px"}
组合逻辑反馈环路是一种**高风险**设计方式,主要原因如下:
@@ -748,9 +746,9 @@ case (var)
## 5.3 脉冲产生器
在异步时序设计中,常用延时链(Delay Chains)产生脉冲,常用的异步脉冲产生方法如[图 5-13](#图 5-13) 所示。
在异步时序设计中,常用延时链(Delay Chains)产生脉冲,常用的异步脉冲产生方法如[图 5-13](#fig. 5-13) 所示。
<a name="图 5-13"></a>
<a name="fig. 5-13"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-130-AsynchronousPulseGeneration.png!sign" width="500px" alt="常用的异步脉冲产生方法示意图"/>
</div>
@@ -759,9 +757,9 @@ case (var)
异步脉冲序列产生电路(Multi-Vibrators)也被称为毛刺生成器(Glitch Generator),**利用组合反馈环路振荡而不断产生毛刺**。正如前面所述,组合反馈环是同步时序必须避免的.这类基于组合反馈环的 Multi-Vibrator 也会给设计带来稳定性、可靠性等方面的问题,必须避免使用。
同步时序设计脉冲电路的常用方法如[图 5-14](#图 5-14) 所示。该设计的脉冲宽度不因器件或设计移植而改变,恒等于时钟周期,而且避免了异步设计的诸多不确定因素,其时序路径便于计算、STA 分析和仿真验证。
同步时序设计脉冲电路的常用方法如[图 5-14](#fig. 5-14) 所示。该设计的脉冲宽度不因器件或设计移植而改变,恒等于时钟周期,而且避免了异步设计的诸多不确定因素,其时序路径便于计算、STA 分析和仿真验证。
<a name="图 5-14"></a>
<a name="fig. 5-14"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-140-SynchronousPulseGeneration.png!sign" width="500px" alt="常用的同步脉冲产生方法示意图"/>
</div>
@@ -793,9 +791,9 @@ end
endmodule
` ``
上述描述,由于未指定在条件 ` cond_1` 等于 ` 0` 时的动作,一般情况下会生成 Latch 结构如[图 5-15](#图 5-15) 所示。
上述描述,由于未指定在条件 ` cond_1` 等于 ` 0` 时的动作,一般情况下会生成 Latch 结构如[图 5-15](#fig. 5-15) 所示。
<a name="图 5-15"></a>
<a name="fig. 5-15"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-150-LatchRTL.png!sign" width="400px" alt="Latch 的 RTL 示意图"/>
</div>
@@ -815,12 +813,11 @@ endmodule
## 6.1 内部逻辑产生的时钟
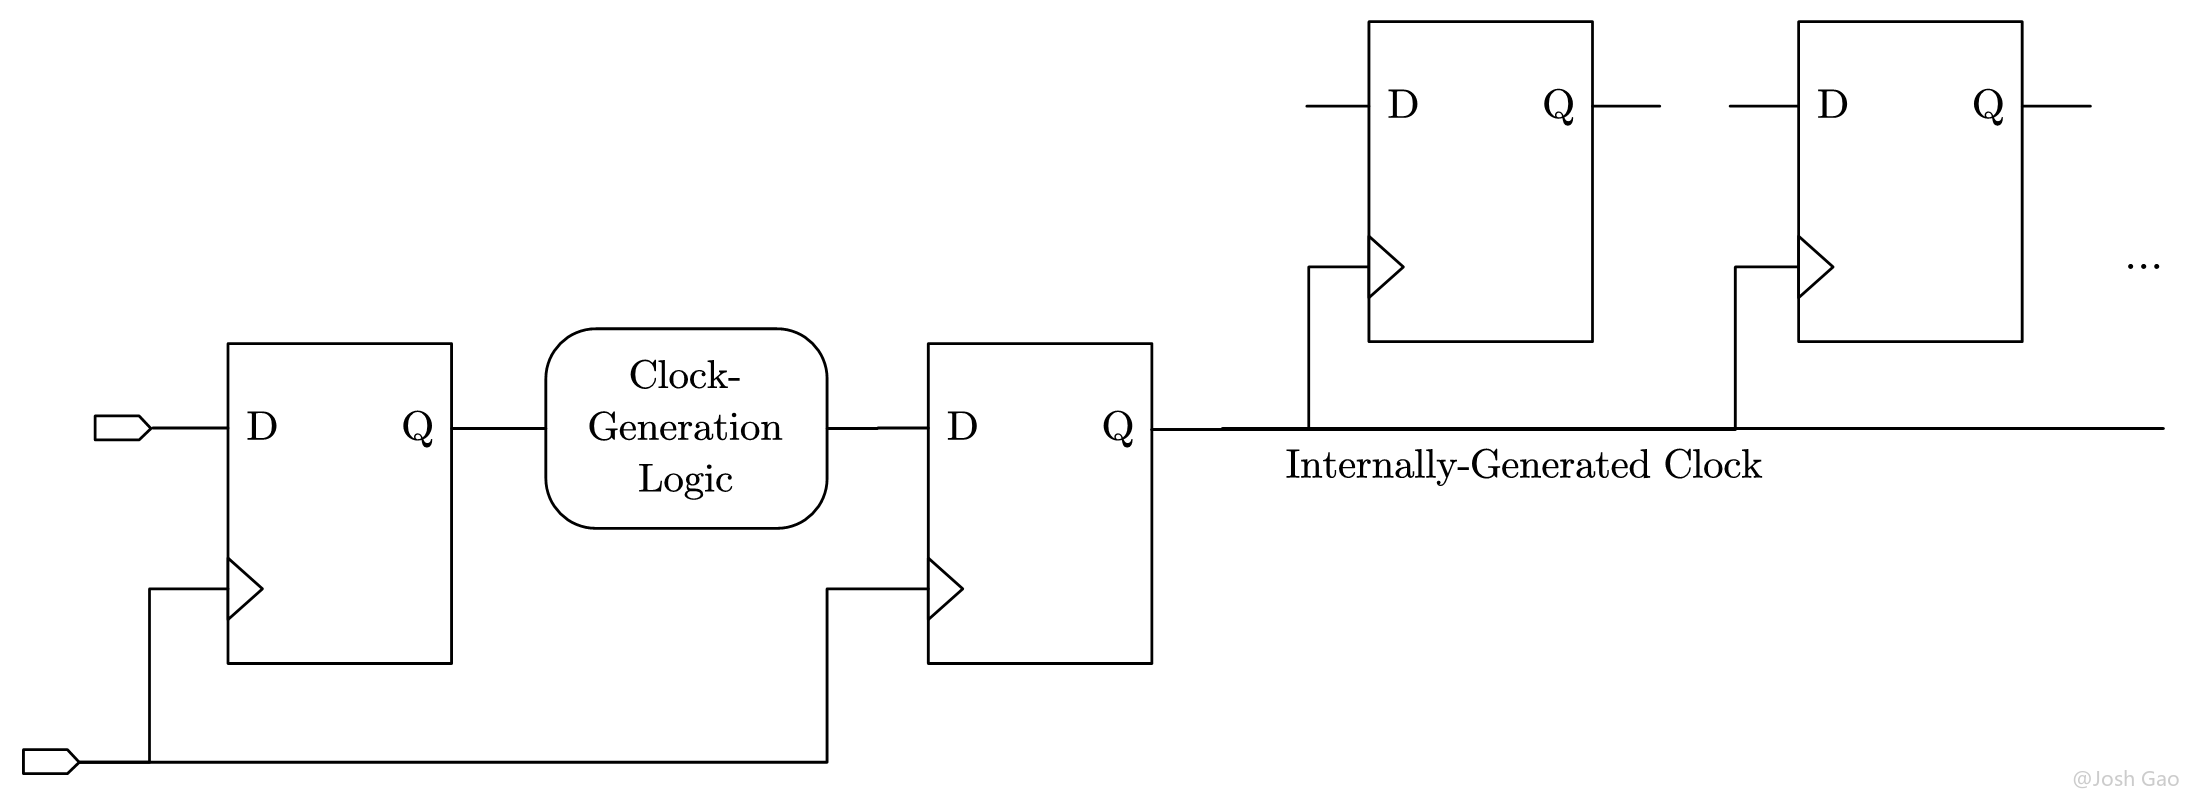
**如果需要使用内部逻辑产生时钟,必须要在组合逻辑产生的时钟后插入寄存器**,如[图 5-16](#图 5-16) 所示。如果直接使用组合逻辑产生的信号作为时钟信号或者异步置位/复位信号,会使设计不稳定。这是因为组合逻辑难免产生毛刺,这些毛刺到达一般数据路径,在经过寄存器采用后一般影响不大,但是如果作为时钟信号或者异步置位/复位信号时,如果毛刺的宽度足以驱动寄存器的时钟端或者异步置位/复位端,则必将产生错误的逻辑操作;即使毛刺的宽度不足以驱动时钟端或异步置位/复位端,也会带来寄存器的不稳定,甚至激发寄存器产生亚稳态。所以对于时钟路径,必须插入寄存器以过滤毛刺。
**如果需要使用内部逻辑产生时钟,必须要在组合逻辑产生的时钟后插入寄存器**,如[图 5-16](#fig. 5-16) 所示。如果直接使用组合逻辑产生的信号作为时钟信号或者异步置位/复位信号,会使设计不稳定。这是因为组合逻辑难免产生毛刺,这些毛刺到达一般数据路径,在经过寄存器采用后一般影响不大,但是如果作为时钟信号或者异步置位/复位信号时,如果毛刺的宽度足以驱动寄存器的时钟端或者异步置位/复位端,则必将产生错误的逻辑操作;即使毛刺的宽度不足以驱动时钟端或异步置位/复位端,也会带来寄存器的不稳定,甚至激发寄存器产生亚稳态。所以对于时钟路径,必须插入寄存器以过滤毛刺。
<a name="图 5-16"></a>
<div align="center">
<img src=" https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-160-InternalClockDesignwithRegister.png!sign" width=" 800px" alt="内部时钟设计必须插入寄存器"/>
</div>
<a name="fig. 5-16"></a>
{ width=800px}
另一方面,组合逻辑产生的时钟还会带来另外一个问题,组合逻辑电路的 Jitter 和 Skew 都比较大,如果时钟产生逻辑的延迟比数据路径的延迟更大,会带来负的 Skew,负的 Skew 同步逻辑设计是灾难性的。所以**使用组合逻辑产生内部时钟仅适用于时钟频率较低、时钟精度要求不高的情况**。另外,**这类时钟应该使用快速布线资源布线,而且需要对组合逻辑电路附加一定的约束条件,以确保时钟质质量**。
@@ -840,18 +837,18 @@ endmodule
## 6.4 门控时钟
门控时钟即 Gated Clock,如[图 5-17](#图 5-17) 所示,是 IC 设计的一种常用减少功耗的手段。通过 Gating Logic 的控制,可以控制门后端的所有寄存器不再翻转,从而非常有效地节约功耗。
门控时钟即 Gated Clock,如[图 5-17](#fig. 5-17) 所示,是 IC 设计的一种常用减少功耗的手段。通过 Gating Logic 的控制,可以控制门后端的所有寄存器不再翻转,从而非常有效地节约功耗。
<a name="图 5-17"></a>
<a name="fig. 5-17"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-170-GatedClock.png!sign" width="800px" alt="门控时钟"/>
</div>
但是 Gated Clock 不是同步时序电路,其 Gating Logic(门控逻辑)会污染 Clock 的质量,通过控制门后会产生毛刺并使时钟的 Skew(偏斜)、Jitter(延时)等指标恶化。正如“[同步设计原则](#0201)” 一节所述,在同步时序电路中,应该尽量不使用 Gated Clock 。
虽然有些材料指出当功耗成为主要矛盾时,可以使用门控时钟改进电路如[图 5-18](#图 5-18) 所示的电路完成类似门控时钟的功能,但是笔者仍强烈建议在 PLD 设计中不要使用该图所示的门控时钟改进电路。虽然这个改进电路已经在较大程度上解决了门控电路产生的毛刺,但是请读者注意,这个电路工作的前提是时钟源Clock 的占空比(Duty Cycle)是非常理想的 50%,如果时钟的占空比不能保证 50%,则会产生许多有规律的毛刺信号。另外这个电路还有一个前提,那就是 Clock 与 Enable 信号的不布线 Skew 为 0,否则也会造成宽度为 Skew 的毛刺。
虽然有些材料指出当功耗成为主要矛盾时,可以使用门控时钟改进电路如[图 5-18](#fig. 5-18) 所示的电路完成类似门控时钟的功能,但是笔者仍强烈建议在 PLD 设计中不要使用该图所示的门控时钟改进电路。虽然这个改进电路已经在较大程度上解决了门控电路产生的毛刺,但是请读者注意,这个电路工作的前提是时钟源Clock 的占空比(Duty Cycle)是非常理想的 50%,如果时钟的占空比不能保证 50%,则会产生许多有规律的毛刺信号。另外这个电路还有一个前提,那就是 Clock 与 Enable 信号的不布线 Skew 为 0,否则也会造成宽度为 Skew 的毛刺。
<a name="图 5-18"></a>
<a name="fig. 5-18"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-180-ImprovedGatedClock.png!sign" width="800px" alt="门控时钟改进电路"/>
</div>
@@ -862,9 +859,9 @@ endmodule
大多数像寄存器这样的同步单元,都支持时钟的同步使能(Synchronous Clock Enable)。需要注意的是,虽然使能无效时这些单元无输出,但是这种方法并不能如 Gated Clock 一样减少功耗。但 Synchronous Clock Enable 却能够非常方便地完成一些逻辑功能,通过使用同步时钟使能端完成某些逻辑功能,有时可以节约芯片面积并提高设计频率。
同步使能端如[图 5-19](#图 5-19) 所示,上半部分是同步使能功能,在目前大多数的器件上可以直接将使能信号连接到芯片的同步使能端实现,如[图 5-19](#图 5-19) 的下半部分所示。
同步使能端如[图 5-19](#fig. 5-19) 所示,上半部分是同步使能功能,在目前大多数的器件上可以直接将使能信号连接到芯片的同步使能端实现,如[图 5-19](#fig. 5-19) 的下半部分所示。
<a name="图 5-19"></a>
<a name="fig. 5-19"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-190-EnableSynchronization.png!sign" width="500px" alt="同步使能端"/>
</div>
@@ -911,14 +908,14 @@ endmodule
仔细观察一下可以发现:第一种实现方式需要两个 16 位乘法器,同时平方,然后根据输入补码的符号选择输出结果,其关键在于使用了两个乘法器,选择器在乘法器之后;第二种实现方法,首先根据输入补码的符号,换算为正数,然后平方,其关键在于选择器在乘法器之前,仅使用了一个乘法器,节约了资源。第二种实现方式与第一种实现方式相比节约的资源有两部分:第一部分,节约了一个 16 bit 乘法器;第二部分,后者的选择器是 1 bit 判断 8 bit 输出,而前者是 1 bit 判断 16 bit 输出。
两种代码的硬件结构示意图如[图 5-20](#图 5-20) 和图5 - 21 所示。
两种代码的硬件结构示意图如[图 5-20](#fig. 5-20) 和图5 - 21 所示。
<a name="图 5-20"></a>
<a name="fig. 5-20"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-200-TwoMultipliedwithoutResourceSharing.png!sign" width="" alt="未Resource Sharing,
</div>
<a name="图 5-21"></a>
<a name="fig. 5-21"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-210-OneMultipliedwithResourceSharing.png!sign" width="" alt="Resource Sharing,
</div>
@@ -935,9 +932,9 @@ endmodule
## 7.3 逻辑复制
逻辑复制是一种通过增加面积而改善时序条件的优化手段。逻辑复制最常使用的场合是调整信号的扇出。如果某个信号需要驱动后级的很多单元,换句话说,也就是其扇出非常大,那么为了增加这个信号的驱动能力,必须插入很多级 Buffer,这样就在一定程度上增加了这个信号路径的延时。这时可以复制生成这个信号的逻辑,使多路同频同相的信号驱动后续电路,平均到每路的扇出变低,不需要加 Buffer 也能满足驱动能力的要求,这样就节约了该信号的路径时延。用逻辑复制改善扇头电路如[图 5-22](#图 5-22) 所示。
逻辑复制是一种通过增加面积而改善时序条件的优化手段。逻辑复制最常使用的场合是调整信号的扇出。如果某个信号需要驱动后级的很多单元,换句话说,也就是其扇出非常大,那么为了增加这个信号的驱动能力,必须插入很多级 Buffer,这样就在一定程度上增加了这个信号路径的延时。这时可以复制生成这个信号的逻辑,使多路同频同相的信号驱动后续电路,平均到每路的扇出变低,不需要加 Buffer 也能满足驱动能力的要求,这样就节约了该信号的路径时延。用逻辑复制改善扇头电路如[图 5-22](#fig. 5-22) 所示。
<a name="图 5-22"></a>
<a name="fig. 5-22"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-220-DuplicationtoImproveFanOut.png!sign" width="" alt="用逻辑复制改善扇出"/>
</div>
@@ -950,9 +947,9 @@ endmodule
首先看下面的一个加法器资源共享的例子。
这个例子和前面乘法器的例子非常相似,只是将平方器换成了加法器。实现这个加法器也有两种代码写法,对应两种不同的硬件结构,资源共享如[图 5-23](#图 5-23) 所示。
这个例子和前面乘法器的例子非常相似,只是将平方器换成了加法器。实现这个加法器也有两种代码写法,对应两种不同的硬件结构,资源共享如[图 5-23](#fig. 5-23) 所示。
<a name="图 5-23"></a>
<a name="fig. 5-23"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-230-ResourceSharingExample.png!sign" width="700px" alt="资源共享示例"/>
</div>
@@ -1034,7 +1031,7 @@ assign out = ((({8{late}} | in0) + in1) == in2) & en;
endmodule
` ``
<a name="图 5-24"></a>
<a name="fig. 5-24"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-240-BeforeShannonExtension.png!sign" width="" alt="未使用香农扩展前的逻辑表达式对应的RTL视图"/>
</div>
@@ -1060,7 +1057,7 @@ assign out = (late) ? late_eq_1 : late_eq_0;
endmodule
` ``
<a name="图 5-25"></a>
<a name="fig. 5-25"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-250-AfterShannonExtension.png!sign" width="" alt="香农扩展后的逻辑表达式对应的RTL视图"/>
</div>
@@ -1073,7 +1070,7 @@ endmodule
# 8. 小结
[图 5-26 ](#图 5-26 ) 罗列了 RTL 编码的全面设计目标,它们是:
[图 5-26 ](#fig. 5-26 ) 罗列了 RTL 编码的全面设计目标,它们是:
- 时序(Timing):要求设计满足预期的时序约束条件,满足预期频率要求。
- 面积(Areag):要求设计所消耗的资源满足所规划的面积要求。
@@ -1084,7 +1081,7 @@ endmodule
- 功耗(Powerg):要求设计的最大功耗在规定范围之内。
- Vendor Policies(原厂的要求):这里主要指 EDA 工具的优化测量和 PLD 或 ASIC 厂方的设计规格与软硬件需求。
<a name="图 5-26"></a>
<a name="fig. 5-26"></a>
<div align="center">
<img src="https://josh-blog-1257563604.cos.ap-beijing.myqcloud.com/img/2020-12-05-josh-verilog-part-5/2020-12-05-josh-verilog-part-5-260-GoalsofRTLCode.png!sign" width="600px" alt="RTL代码的设计目标"/>
</div>
